02.07.2025
Asana vs. Trello: Welches Projektmanagement-Tool ist besser?
Asana vs. Trello: Welches Projektmanagement-Tool ist besser? Wir vergleichen beide Tools im Projektmanagement. Welches Tool passt besser zu Ihren Zielen?
get started


Eine Analyse von LEAP und SISTRIX ergab, dass rund 73 Prozent der umsatzstärksten deutschen Online-Shops im Herbst 2025 kein A/B-Testing-Tool einsetzten. Das zeigt eine Lücke zwischen vorhandenen digitalen Daten und der systematischen Prüfung von Produktänderungen. Ein Tool allein schließt sie allerdings nicht. Entscheidend ist, ob Ihr Team genug geeignete Daten hat, um einen Split-Test zu rechtfertigen, und ob es vor dem Start festlegt, welche Messung eine Produktentscheidung trägt. (LEAP und SISTRIX zur Verbreitung von A/B-Testing im deutschen E-Commerce)
Eine Analyse von mehr als 127.000 Experimenten kommt auf eine durchschnittliche Erfolgsquote von rund 12 Prozent. Viele Tests liefern also keinen bestätigten Gewinn. Für kleine deutsche SaaS- und B2B-Teams ist das kein Argument gegen Experimente. Es ist ein Grund, vor jedem Split zu fragen, ob ein klassischer A/B-Test die passende Lernmethode ist. (Der Grow Report von konversionsKRAFT)
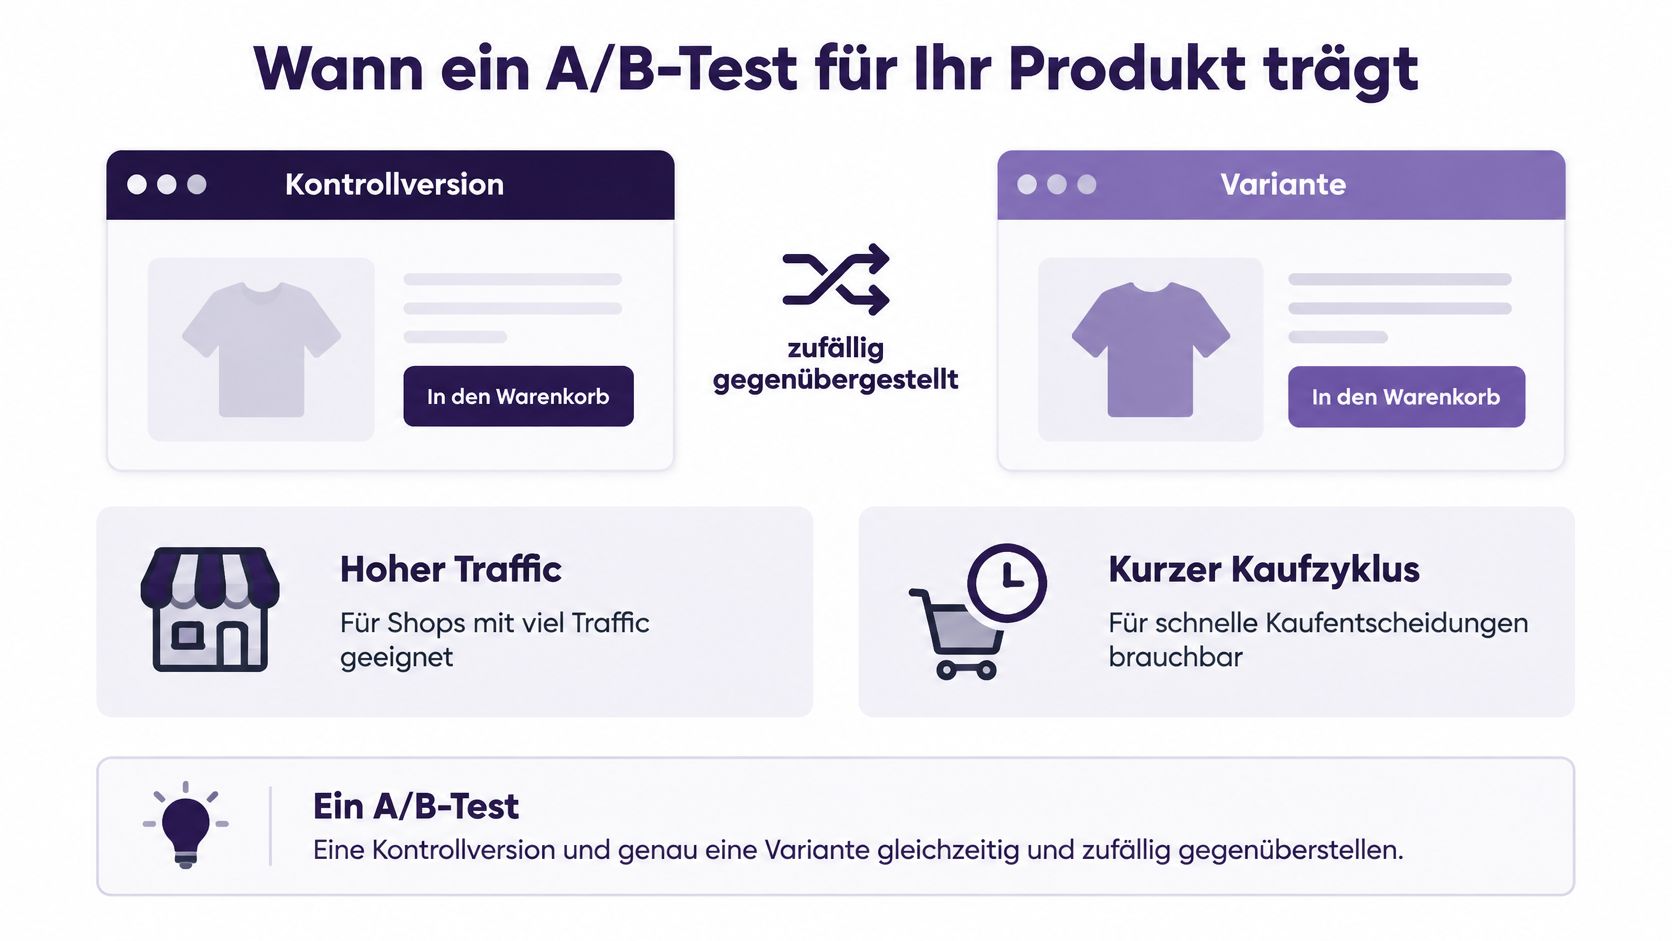
Ein A/B-Test teilt Nutzer zufällig auf eine Kontrollversion und genau eine Variante auf. Beide laufen gleichzeitig. Wenn sich die Gruppen nur durch die getestete Änderung unterscheiden und die Messung zuverlässig ist, lässt sich der Unterschied bei der Zielmetrik eher dieser Änderung zuordnen als bei einem Vorher-Nachher-Vergleich. Das Format eignet sich besonders für Shops mit viel Traffic und kurzen Kaufzyklen, weil sich ausreichend Beobachtungen eher innerhalb einer überschaubaren Laufzeit sammeln lassen.
Bei B2B-Produkten liegt die Herausforderung oft nicht in der technischen Umsetzung, sondern in der Stichprobe. Wenn nur wenige qualifizierte Anfragen eingehen und sich ein Lead über einen langen Sales-Zyklus entwickelt, kann ein belastbarer Split Monate dauern. Eine DACH-Studie mit 98 Unternehmen stellte fest, dass 53 Prozent einen niedrigen Experimentation-Reifegrad haben. Unternehmen, die weniger als zwölf Tests pro Jahr durchführen, liegen mehrheitlich auf diesem Niveau. Diese Befunde sprechen dafür, erst eine verlässliche Lernroutine aufzubauen, statt möglichst viele Tests anzusetzen. (Der Grow Report von konversionsKRAFT)
Die folgende Tabelle ist eine Entscheidungshilfe: Wählen Sie das Lernformat nach Traffic, Zyklus und Reifegrad, nicht nach der Verfügbarkeit eines Testing-Tools.
| Situation | Methode | Entscheidungsgrund |
|---|---|---|
| Hoher Traffic, kurze Conversion | A/B-Test 50:50 | Stichprobe in Wochen erreichbar |
| Wenig B2B-Leads, langer Sales-Zyklus | Interviews plus Vorher-Nachher-Messung | Klassischer Split kann Monate dauern |
| Unter zwölf Tests pro Jahr | Dokumentiertes Lernexperiment | 53 Prozent der untersuchten DACH-Unternehmen hatten einen niedrigen Reifegrad |
| Einzelne UI-Änderung am MVP | Sequenzielle Messung mit Stop-Regel | Ein unterpowerter Split misst vor allem Schwankungen |
| Erwartung vieler schneller Gewinner | Hypothesen priorisieren, nicht wahllos testen | Durchschnittliche Erfolgsquote von rund 12 Prozent |
Bei wenigen Leads können strukturierte Interviews zeigen, warum Interessenten abspringen. UX-Research hilft, konkrete Reibungspunkte in Formularen, Onboarding oder Produktabläufen zu identifizieren. Eine Vorher-Nachher-Messung kann danach nützlich sein, wenn Sie parallel dokumentieren, was sich sonst noch verändert hat. Sie ist kein Ersatz für Randomisierung, aber oft ehrlicher als ein Split, dessen Stichprobe nicht ausreicht.
Entscheidungsregel: Starten Sie einen klassischen Split nur, wenn Sie die nötige Stichprobe im verfügbaren Zeitraum realistisch erreichen. Falls nicht, definieren Sie stattdessen ein enges Lernziel und eine Regel, nach der Sie anschließend entscheiden.
Für frühe Produkte zählt besonders, ob eine Änderung ein relevantes Problem löst. Ein Team kann Hypothesen, Beobachtungen und Entscheidungen in einem dokumentierten MVP-Ansatz festhalten und so vermeiden, dass aus jeder ungeprüften Idee ein Entwicklungsticket wird. Vor dem Kick-off sollten Product, Engineering und Stakeholder dieselbe Ja-oder-Nein-Entscheidung teilen: Reicht die Datenlage für einen A/B-Test, oder wählen wir ein anderes Lernformat?
Ein A/B-Test beginnt nicht mit dem Einschalten eines Tools, sondern mit einem vorab festgelegten Protokoll. Es hält fest, welche Ursache Sie untersuchen, woran Sie Erfolg messen und unter welchen Bedingungen Sie auswerten. Das schützt das Team davor, nach dem Start Metriken oder Regeln so zu ändern, dass das Ergebnis besser zur bevorzugten Lösung passt.
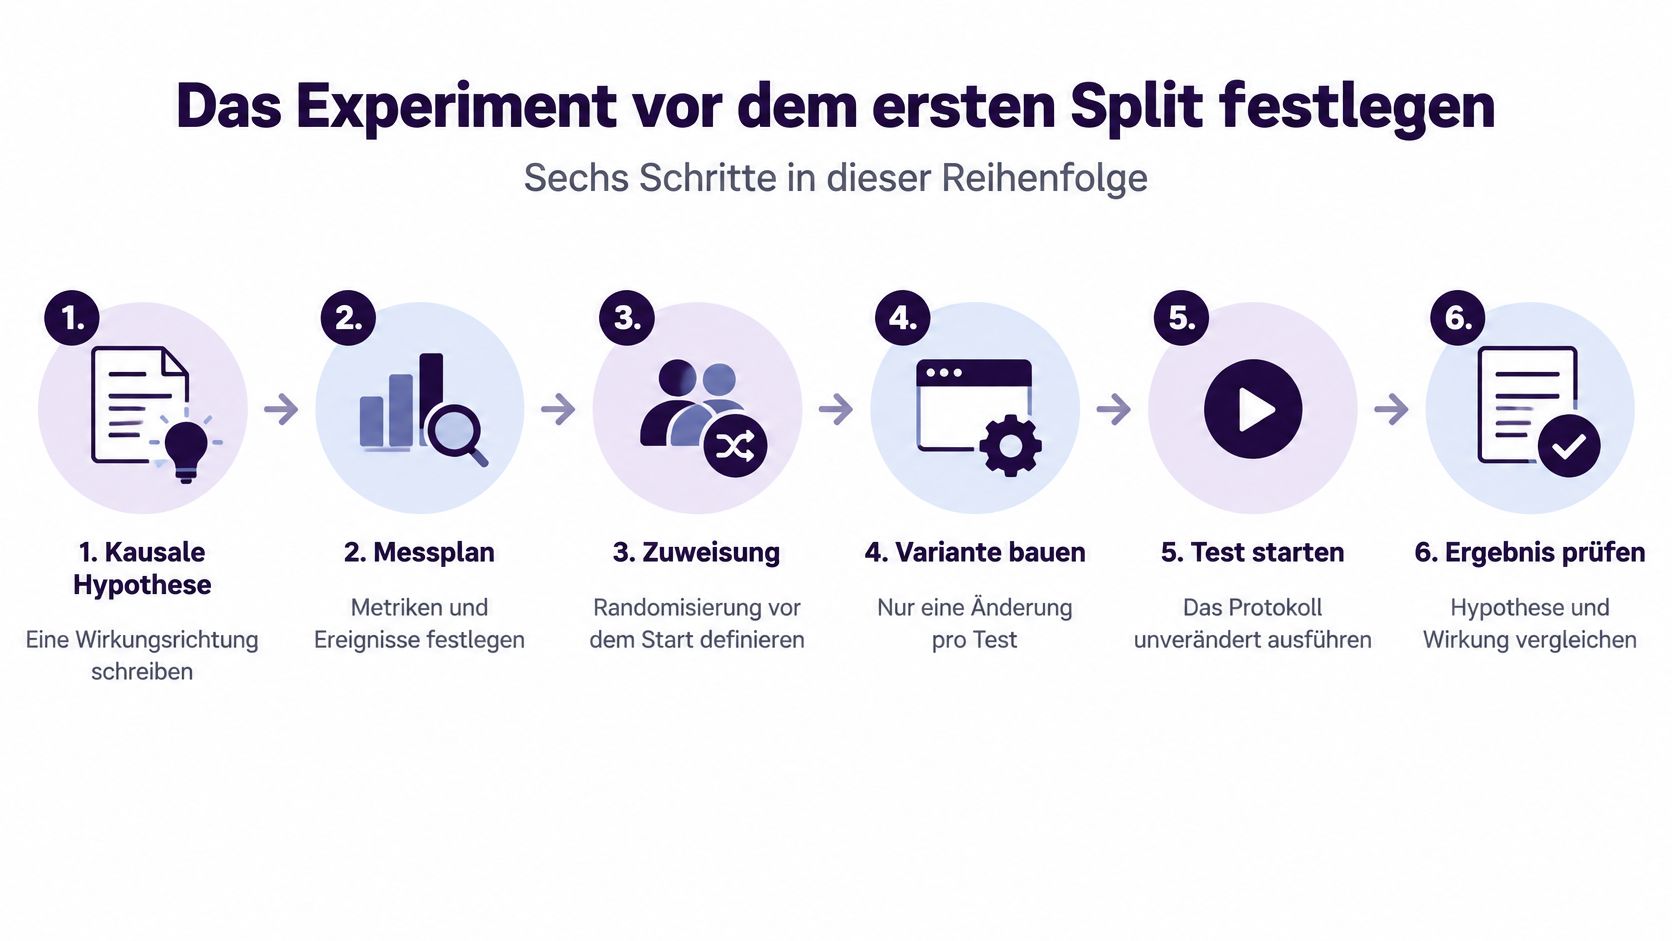
Ein kontrolliertes Experiment für ein deutsches SaaS- oder Recruiting-Produkt lässt sich in sechs Schritten planen. Die Reihenfolge ist wichtig, denn Stichprobe und Auswertung hängen von der Hypothese und der Zielmetrik ab. (Praxisanleitung von Xictron zum A/B-Testing)
Formulieren Sie eine kausale Hypothese. Beschreiben Sie eine erwartete Wirkungsrichtung, nicht nur eine Änderung. Zum Beispiel: „Eine präzisere Darstellung seniorer Entwickler reduziert die Zeit bis zur qualifizierten Anfrage.“ So kann das Team später prüfen, ob sowohl die angenommene Ursache als auch die Wirkung plausibel sind.
Wählen Sie genau eine Primärmetrik. Bei einem B2B-Angebot können qualifizierte Anfragen oder gebuchte Erstgespräche aussagekräftiger sein als bloße Klicks. Die Kennzahl muss das Geschäftsziel abbilden und ein Ereignis haben, das Engineering zuverlässig erfassen kann.
Dokumentieren Sie die Parameter. Notieren Sie die Baseline-Conversion-Rate, den Minimum Detectable Effect (MDE), das Signifikanzniveau und die statistische Power. Als übliche Konfiguration gelten 5 Prozent Signifikanzniveau, entsprechend 95 Prozent Konfidenz, und 80 Prozent Power. Der MDE beschreibt den kleinsten Effekt, der für Ihre Entscheidung noch relevant wäre.
Definieren Sie die Zuweisung vor dem Start. Weisen Sie Nutzer zufällig und, sofern das Experimentdesign nichts anderes verlangt, möglichst im Verhältnis 50:50 der Kontroll- und Testvariante zu. Entscheiden Sie zudem, ob die Zuweisung für wiederkehrende Nutzer stabil bleibt.
Führen Sie beide Varianten parallel aus. Planen Sie die Laufzeit über vollständige Wochenzyklen, damit beide Gruppen vergleichbare Zeiträume abdecken. Vermeiden Sie, dass nur eine Variante während einer Kampagne oder eines Releases aktiv ist.
Werten Sie erst nach Erreichen der berechneten Stichprobe aus. Die vorab geplante Zahl schützt davor, ein vorläufiges Muster mit einem belastbaren Ergebnis zu verwechseln. Fehlt im geplanten Zeitfenster der notwendige Traffic, ist ein anderer Lernansatz sinnvoller als ein endlos verlängerter Split.
Die Größenordnung wird an einer einfachen Conversion-Metrik deutlich: Bei einer Ausgangs-Conversion von 2 bis 3 Prozent und einem erwarteten relativen Uplift von 10 Prozent können grob 20.000 bis 40.000 Sessions je Variante nötig sein. (Xictron zur Stichprobenplanung beim A/B-Testing)
| Primärmetrik | Baseline | Relativer MDE | Sessions je Variante | Konfidenz und Power |
|---|---|---|---|---|
| Conversion Rate | 2–3 % | 10 % | 20.000–40.000 | 95 % / 80 % |
| Qualifizierte Anfrage | Vorab anhand eigener Daten messen | 10 % | Bei niedriger Baseline höher als bei 2–3 % | 95 % / 80 % |
| Gebuchte Erstbesprechung | Vorab anhand eigener Daten messen | Vorab festlegen | Vor dem Start berechnen | 95 % / 80 % |
| Klickrate als Ersatzziel | Nicht verwenden | Nicht relevant | Nicht relevant | Bildet Vertriebsqualität nicht zuverlässig ab |
Für qualifizierte Anfragen und gebuchte Erstgespräche liefert die Quelle keine allgemeingültige Baseline. Verwenden Sie deshalb Ihre eigenen historischen Daten, und berechnen Sie die Stichprobe, bevor Engineering den Split aktiviert. Eine Guardrail-Metrik wie Support-Aufkommen oder Abbrüche kann parallel sichtbar machen, ob die Änderung an anderer Stelle schadet. Sie entscheidet aber nicht anstelle der Primärmetrik über den Gewinner.
Feature-Flags helfen, die technische Auslieferung einer Variante von der Analyse zu trennen. Das Team kann damit die Änderung kontrolliert ein- oder ausschalten, ohne die Zielmetrik spontan zu ändern. Wenn die geplante Stichprobe im verfügbaren Zeitraum nicht erreichbar ist, sollten Sie den Split nicht als statistischen Nachweis behandeln. Nutzen Sie ein anderes Lernformat, das zur Datenlage passt.
Hier ist das Video zum Ablauf eines Experiments:
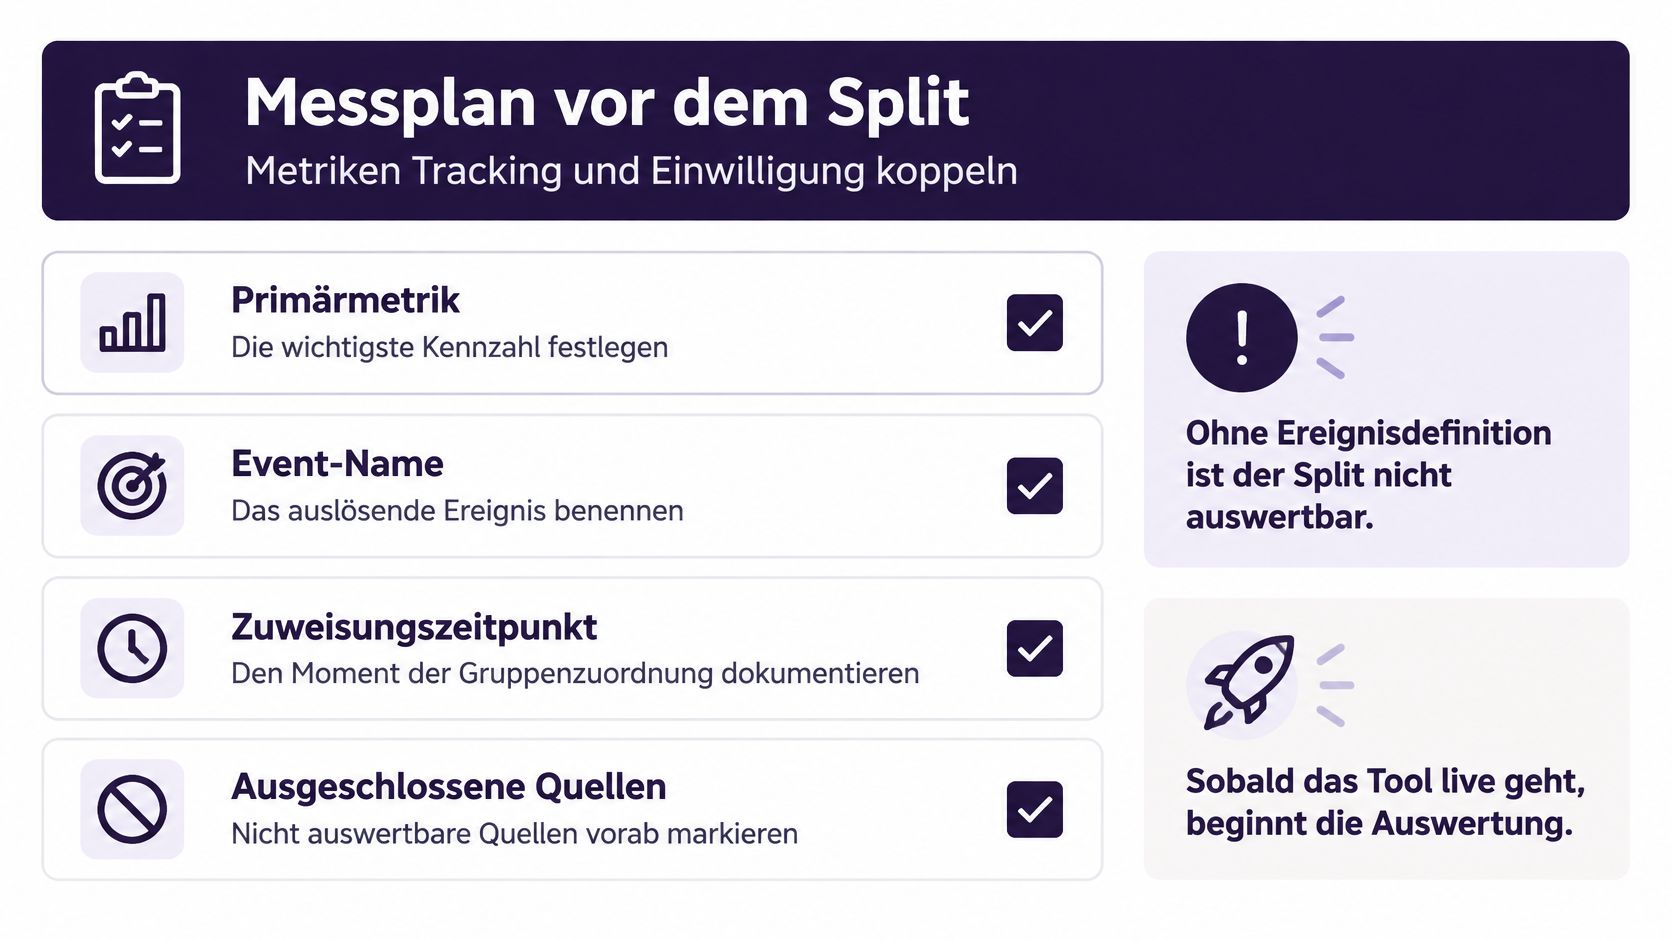
Ein Test ist nur auswertbar, wenn die technische Messung dieselbe Bedeutung hat wie die Produktmetrik. Legen Sie vor dem Start den Event-Namen, den Zeitpunkt der Gruppenzuweisung, die Primärmetrik und die ausgeschlossenen Traffic-Quellen fest. Wenn „qualifizierte Anfrage“ im Produktteam eine abgeschickte Anfrage meint, im Tracking aber jeder Klick auf den Kontaktbutton zählt, vergleichen Sie zwei unterschiedliche Dinge.
In Deutschland ist die Reihenfolge der Testzuweisung auch eine rechtliche und technische Planungsfrage. Sobald ein A/B-Testing-Tool Cookies oder andere Informationen auf dem Endgerät speichert oder ausliest, greift in der Regel § 25 TDDDG. In diesem Fall muss die Einwilligung vor der Testzuweisung vorliegen. Für Verhaltensdaten wie Klickpfade, Heatmaps oder Session-Aufzeichnungen braucht es zusätzlich eine Rechtsgrundlage nach Art. 6 DSGVO. (Praxisbeitrag zu A/B-Testauswertung, Consent und Tracking)
Bauen Sie das Consent-Gate so, dass ein Nutzer ohne erforderliche Einwilligung nicht versehentlich in einen zustimmungspflichtigen Test gelangt. Für die Stichprobenplanung zählt deshalb nicht der gesamte Website-Traffic, sondern nur der tatsächlich nutzbare, consent-konforme Traffic. Wer die gesamte Reichweite ansetzt, überschätzt möglicherweise, wie viele Sessions für die Auswertung übrig bleiben.
Ein sauberes Setup trennt Zuweisung und Analyse. Die Zuweisung legt fest, welche Erfahrung ein Nutzer sieht; das Analytics-System erfasst anschließend die vereinbarten Ereignisse. Eine serverseitige Zuweisung kann die Variante konsistent halten, wenn Browser-Cookies gelöscht werden oder ein Nutzer Tracking ablehnt. Die konkrete Architektur muss allerdings mit dem Consent-Management und der gewählten Rechtsgrundlage zusammenpassen. Für die Umsetzung und Prüfung solcher Anforderungen können Teams ihre Compliance-Anforderungen für digitale Produkte systematisch erfassen.
Der Messplan sollte mindestens vier Punkte enthalten:
Prüfen Sie vor dem Start auf Mobile und Desktop, ob in beiden Varianten dieselben Events feuern. Vergleichen Sie außerdem die Ladezeit: Eine langsamere Variante kann Verhalten verändern, obwohl die inhaltliche Änderung keinen Effekt hatte. Bot-Traffic und interne IPs dürfen nicht unbemerkt in die geplante Stichprobe einfließen.
Das Team sollte vor dem Livegang nachvollziehen können, wie ein Einwilligungsstatus die Zuweisung und Messung beeinflusst. Halten Sie Testgruppe, Ereignisdefinition und consent-konforme Sample-Basis im Messplan fest. Dann lässt sich nach dem Test erklären, welche Daten tatsächlich verglichen wurden und welche nicht.
Ein scheinbarer Gewinner rechtfertigt keinen Rollout, wenn die Datenqualität oder die vorab festgelegten Auswertungsregeln nicht stimmen. Legen Sie Stichprobe, Laufzeit, Primärmetrik und Auswertungsmethode fest, bevor Nutzer die Varianten sehen. So bleibt die Entscheidungsgrundlage stabil, auch wenn das Dashboard zwischenzeitlich günstige Zahlen zeigt. (Praxisempfehlungen zur statistischen Signifikanz beim A/B-Testing)
Stop-Regel für tägliches Peeking: Werten Sie einen Test mit festgelegter Stichprobe nicht täglich aus, um beim ersten günstigen Zwischenstand einen Gewinner auszurufen. Bei einem Signifikanzniveau von 5 Prozent besteht bei einem ungeplanten Testabschluss ein Fehlalarmrisiko. Wiederholtes Prüfen erhöht die Chance, einen zufälligen Ausschlag für einen echten Effekt zu halten. Nutzen Sie das Dashboard während des Tests zur technischen Überwachung, nicht zur vorzeitigen Entscheidung.
Stop-Regel für Sample-Ratio-Mismatch: Prüfen Sie vor dem Variantenvergleich, ob die tatsächliche Zuweisung nahe am geplanten 50:50-Split liegt. Eine deutliche Abweichung kann auf Trackingfehler, Cookie-Löschung, Bot-Traffic oder technische Unterschiede zwischen den Gruppen hinweisen. Ist die Verteilung nicht plausibel, halten Sie die Auswertung an und klären Sie die Ursache.
Stop-Regel für die Laufzeit: Lassen Sie beide Varianten über vollständige Wochenzyklen laufen. So sind Wochentage in beiden Gruppen gleichmäßig vertreten und der Wochenrhythmus wird nicht mit einem Varianten-Effekt verwechselt. Die Laufzeit allein ersetzt keine ausreichende Stichprobe.
Stop-Regel für viele Segmente: Behandeln Sie Auswertungen nach Gerät, Trafficquelle oder Unternehmensgröße als sekundär, sofern sie nicht vorab als eigene Fragestellung festgelegt wurden. Je mehr Gruppen nachträglich untersucht werden, desto größer ist die Chance auf zufällig auffällige Unterschiede. Ein Gewinn auf einer Sekundärmetrik oder in einem nachträglich ausgewählten Segment reicht nicht, wenn die Primärmetrik insgesamt flach bleibt.
Während des Tests sollten Sie Kampagnen, Preise und parallele Produkt-Releases möglichst einfrieren. Ändern sich diese Faktoren gleichzeitig, lässt sich ein beobachteter Unterschied nicht zuverlässig der getesteten Variante zuordnen. Enthält eine Variante mehrere Änderungen, kann das Team außerdem die ursprüngliche Hypothese nicht sauber prüfen.
Prüfen Sie Flicker, also das sichtbare Aufblitzen der alten Version vor der neuen, sowie ungleiche Ladezeiten. Eine Variante, die später oder unvollständig erscheint, kann die Nutzung unabhängig von ihrem Inhalt verändern. Prüfen Sie auf Mobile und Desktop Darstellung, Event-Auslösung und die Zeit bis zum ersten sinnvollen Inhalt. Interne Nutzer, Support-Zugriffe und Bots gehören bereits vor dem Start auf die Ausschlussliste.
Ein Konfidenzintervall, das den Null-Effekt einschließt, beweist nicht, dass eine Produktidee wertlos ist. Der Test kann den relevanten Effekt möglicherweise nicht klar auflösen oder die Änderung wirkt kleiner als der vorab festgelegte MDE. Halten Sie das Ergebnis dann als unklar fest, statt es als Gewinn oder Niederlage umzudeuten. Auch ohne Rollout kann ein Test die nächste Produktentscheidung informieren, wenn das Team dokumentiert, was es gelernt hat.
| Fehler | Folge | Stop-Regel |
|---|---|---|
| Tägliches Peeking | Kumulative Fehlalarme | Erst nach der geplanten Stichprobe auswerten |
| Sample-Ratio-Mismatch | Verzerrte Gruppen | Zuweisung nahe 50:50 vor der Analyse prüfen |
| Unvollständige Wochenzyklen | Wochentagseffekte | Beide Varianten über vollständige Wochenzyklen laufen lassen |
| Viele nachträgliche Segmente | Höhere Fehlerrate | Primärmetrik entscheidet; Segmente nur bei vorab festgelegter Fragestellung bewerten |
| Rollout vor voller Stichprobe | Möglicher Scheingewinner im Produkt | Evidenz und Datenqualität abwarten |
| Mehr als eine Änderung je Variante | Hypothese nicht kausal prüfbar | Kampagnen, Preise und Releases einfrieren |
| Flicker oder ungleiche Ladezeit | Scheineffekt durch technische Unterschiede | Mobile und Desktop vor dem Merge prüfen |
Jeder Test sollte mit Hypothese, tatsächlicher Stichprobe, Ergebnis und nächster Produktentscheidung enden. Das Ergebnis kann „ausrollen“, „nicht ausrollen“ oder „nicht eindeutig“ lauten. Für den Überblick über Produktziele und Kennzahlen können Teams ihre KPIs und Business Intelligence so strukturieren, dass Primärmetrik und technische Kontrollwerte getrennt sichtbar sind.
Vor dem Merge: Prüfen Sie, ob die geplante Stichprobe erreicht wurde, die Datenverteilung plausibel ist, die Primärmetrik die Entscheidung stützt und die Variante ohne technische Nebenwirkungen funktioniert. Fehlt eine dieser Grundlagen, stoppen Sie den Rollout.
Google Optimize und Optimize 360 wurden am 30. September 2023 eingestellt. Experimente und Personalisierungen, die zu diesem Zeitpunkt noch liefen, wurden beendet. Für Teams mit älteren Analytics-Setups sind gespeicherte Testdefinitionen daher keine aktive Grundlage für neue Experimente. Prüfen Sie Variantenlogik und Tracking, bevor Sie sie erneut verwenden. (Google Analytics zur Einstellung von Google Optimize
Vor der Wahl eines neuen Tools sollte ein CTO oder Product Lead prüfen, wie es mit dem vorhandenen Analytics-System, Consent-Management, Feature-Flags und serverseitiger Auslieferung zusammenspielt. Bei consentabhängigen Tests darf die Zuweisung erst erfolgen, wenn die erforderliche Einwilligung vorliegt. Klären Sie außerdem, wie eine Variante nach dem Löschen von Cookies konsistent bleibt, etwa über eine serverseitige Zuweisung, die mit dem Consent-Management abgestimmt ist. Trennen Sie die technische Auslieferung von der Auswertung und legen Sie fest, welche Daten erfasst werden dürfen.
Einzelne Marketingtests schaffen noch keine stabile Experimentierfähigkeit. Benennen Sie im Produktteam eine Person, die Hypothesen-Backlog, Primärmetrik und Stop-Regel zusammenhält. Engineering verantwortet Feature-Flags, stabile Events und einen Deployment-Prozess, der getestete Änderungen nicht unbemerkt mit anderen Releases vermischt.
Jede Idee sollte vor dem Engineering-Ticket die erwartete Wirkungsrichtung, eine Primärmetrik und eine realistische Stichprobenplanung enthalten. So lässt sich vor dem Bau eines Flags prüfen, ob ein Split im vorgesehenen Zeitfenster sinnvoll ist. Reicht der qualifizierte Traffic nicht aus, planen Sie stattdessen ein Lernformat mit Interviews oder UX-Research. Ist auch das nicht passend, verzichten Sie ausdrücklich auf eine belastbare Aussage.
Archivieren Sie frühere Optimize-Auswertungen, aber übernehmen Sie sie nicht automatisch als aktive Ziele. Prüfen Sie Event-Namen, Variantenlogik und Consent-Gate erneut, bevor historische Metriken in einen neuen Test einfließen. Die verantwortliche Person kann Laufzeit und technische Auslieferung kontrollieren, ohne aus vorläufigen Ergebnissen einen Gewinner abzuleiten.
Das nächste Experiment muss kein Split-Test sein. Bei ausreichender Stichprobe eignet sich ein dokumentierter A/B-Test; bei zu wenig Daten ist ein bewusst nicht-statistisches Lernformat oder der Verzicht auf einen Gewinner die bessere Entscheidung. In beiden Fällen sollten Lernziel, Messung und nächste Produktentscheidung nachvollziehbar bleiben.
PandaNerds stellt erfahrene Entwicklerinnen und Entwickler bereit, die sich in bestehende Engineering-Teams integrieren und beispielsweise Feature-Flags, Tracking oder Produktänderungen umsetzen können. Wenn Ihr Team ein Experiment technisch vorbereiten oder begründet auf einen Split verzichten möchte, kann es mit PandaNerds über passende Unterstützung sprechen.