02.07.2025
Asana vs. Trello: Welches Projektmanagement-Tool ist besser?
Asana vs. Trello: Welches Projektmanagement-Tool ist besser? Wir vergleichen beide Tools im Projektmanagement. Welches Tool passt besser zu Ihren Zielen?
get started


Ein Engineering Lead öffnet das Jira-Board und sieht eine lange Reihe offener Tickets. Drei Stakeholder nennen jeweils ihr Thema dringend, die Sprintplanung rückt näher und niemand kann sauber erklären, warum ein Item vor einem anderen steht. Am Ende wird sortiert, verschoben und kommentiert. Die Entscheidung hält bis zum nächsten dringenden Wunsch.
Das ist kein Jira-Problem. Backlog Priorisierung ist eine Führungs- und Prozessdisziplin. Ein Backlog wird nicht durch ein einzelnes Refinement gut, sondern durch wiederholbare Entscheidungen, klare Verantwortlichkeiten und eine nachvollziehbare Logik. Eine Einordnung zu agiler Softwareentwicklung hilft beim methodischen Rahmen, ersetzt aber keine konkrete Arbeitsweise im Team.
Die erste Ursache liegt in der Vermischung von Wunsch und Wert. Ein Stakeholder bringt eine Funktion ein, weil sie in einem Kundentermin versprochen wurde. Ein anderer fordert technische Modernisierung, weil ein Entwickler Risiken sieht. Beide Anliegen können legitim sein. Keines ist deshalb automatisch wichtiger als das andere.
Ein belastbarer Backlog-Eintrag braucht mindestens einen nachvollziehbaren Grund, eine erwartete Wirkung, erkennbare Abhängigkeiten und eine grobe Einschätzung des Aufwands. Fehlt diese Basis, gewinnt meist die lauteste Person im Raum. Genau das widerspricht dem Zweck eines Product Backlogs, das in einer deutschen Interviewstudie als priorisierte Liste von Features, Funktionalitäten und Verbesserungsmöglichkeiten beschrieben wird. Die Priorisierung soll im Refinement regelmässig angepasst werden, damit die Einträge für Sprint-Planungen nutzbar bleiben. Die Studie zu Scrum und Product Backlogs zeigt ausserdem, dass in zwei befragten Fällen gar keine Priorisierung vorlag. Entwickler mussten selbst entscheiden oder wiederholt beim Kunden nachfragen.
Das deutsche Requirements Engineering bewegt sich seit längerem zwischen strukturierten Dokumenten, User Stories und Backlogs. Eine Fraunhofer-IESE-Erhebung nennt dabei 17 % der befragten Organisationen mit einer reinen Backlog-Vorgehensweise, 71 % mit strukturierter natürlicher Sprache und 65 % mit textbasierten Use Cases oder User Stories. Im selben Kontext wird „Anforderungen priorisieren & abstimmen“ als eigener Bestandteil der Arbeit mit Anforderungen genannt. Die Übersicht zum agilen Anforderungsmanagement macht damit deutlich, dass Priorisierung nicht an ein bestimmtes Tool gebunden ist.
Praktische Regel: Jede Prioritätsentscheidung braucht einen Owner, eine Begründung und einen Zeitpunkt für die nächste Überprüfung.
Der Product Owner trägt die Entscheidung. Engineering liefert die technische Realität, Stakeholder liefern Kontext und der CTO setzt Grenzen bei Risiko, Budget und strategischer Richtung. Niemand sollte die Verantwortung an ein Board oder an eine Formel delegieren.
Keines dieser Modelle ist eine universelle Wahrheit. Sie lösen unterschiedliche Probleme und verlangen unterschiedliche Datenqualität. Wer ein Modell auswählt, sollte zuerst prüfen, welche Information tatsächlich belastbar vorliegt.
RICE bewertet typischerweise Reichweite, Wirkung, Sicherheit und Aufwand. Das erzeugt eine quantitative Punktzahl und eignet sich gut für Discovery, wenn Nutzungsdaten oder Experimente vorhanden sind. Ohne verlässliche Reichweiten- und Impact-Annahmen verwandelt sich RICE allerdings in präzise aussehende Spekulation.
WSJF richtet den Blick auf Verzögerungskosten und die relative Grösse eines Jobs. Das passt zu Portfolio- und Programmentscheidungen, besonders wenn mehrere Teams an wirtschaftlich verbundenen Vorhaben arbeiten. Die Methode funktioniert nur, wenn Stakeholder wirtschaftliche Wirkung, Zeitkritikalität, Risiko und Umfang wenigstens relativ einschätzen können. Die Erläuterung zu Cost of Delay und WSJF beschreibt genau diesen Zusammenhang zwischen späterem Nutzen, Verzögerungskosten und relativer Bewertung.
MoSCoW ist der schnellste Einstieg. Die vier Klassen Must Have, Should Have, Could Have und Won't Have trennen nicht nur Wichtiges von weniger Wichtigem, sondern machen auch bewusste Nicht-Ziele sichtbar. Die Methode stammt aus DSDM und dient zugleich als Scope-Management. Die Beschreibung der MoSCoW-Methode zeigt, warum diese explizite Begrenzung für Releases wertvoll ist. Bei einem sehr grossen Backlog bleibt MoSCoW jedoch grob.
Relative Weight bewertet jedes Item anhand von Vorteilen, Strafen, Risiken und Kosten. Die deutschsprachige Beschreibung nennt dafür eine Skala von 1 bis 9, wodurch sich Items vergleichbar bewerten lassen. Die Erklärung von Relative Weight ist besonders für kleine, bereits gut verstandene Backlogs relevant. Das Modell reduziert die Abhängigkeit von geschönten Impact-Zahlen, weil die Items relativ zueinander betrachtet werden.
| Kriterium | RICE | WSJF | MoSCoW | Relative Weight |
|---|---|---|---|---|
| Teamgrösse | Kleine bis mittlere Produktteams | Mehrere Teams oder Portfolioebene | Ein Team oder ein klar abgegrenztes Release | Kleine, erfahrene Teams |
| Datentransparenz | Hoch, Nutzungs- und Wirkungsdaten nötig | Mittel bis hoch, wirtschaftliche Annahmen nötig | Niedrig bis mittel | Mittel, relative Einschätzungen reichen |
| Time-to-Value | Gut für Hypothesen und Experimente | Sehr gut bei zeitkritischen Vorhaben | Gut für harte Release-Grenzen | Gut bei überschaubaren Items |
| Stakeholder-Druck | Wird durch Scores strukturiert | Wird durch Cost of Delay versachlicht | Wird durch explizite Ausschlüsse sichtbar | Wird durch Vergleich statt Einzelargumente begrenzt |
| Einführung | Mittlerer Aufwand | Höherer Abstimmungsaufwand | Schnell | Mittlerer Workshopaufwand |
| Schwäche | Scheingenauigkeit bei schlechten Daten | Abhängigkeit von Wirtschaftlichkeitsannahmen | Geringe Trennschärfe bei vielen Items | Weniger geeignet für grosse, unreife Backlogs |
Meine Empfehlung ist klar: Kein Framework-Tourismus. Startet mit MoSCoW, wenn Scope-Klarheit das akute Problem ist. Nutzt RICE für datenreiche Discovery, WSJF für portfolioübergreifende Entscheidungen und Relative Weight für kleine Backlogs mit erfahrenen Beteiligten. Ein Team darf für verschiedene Entscheidungsebenen unterschiedliche Modelle verwenden, aber nicht für dieselbe Ebene ständig wechseln.
Priorisierung beginnt nicht im Refinement. Sie beginnt dort, wo eine neue Anfrage ins Unternehmen gelangt. Ohne Intake-Filter landen Kundenwünsche, technische Risiken, Vertriebszusagen und interne Ideen im selben Stapel. Das Team muss dann zuerst die Herkunft und Bedeutung rekonstruieren, statt Produktentscheidungen zu treffen.
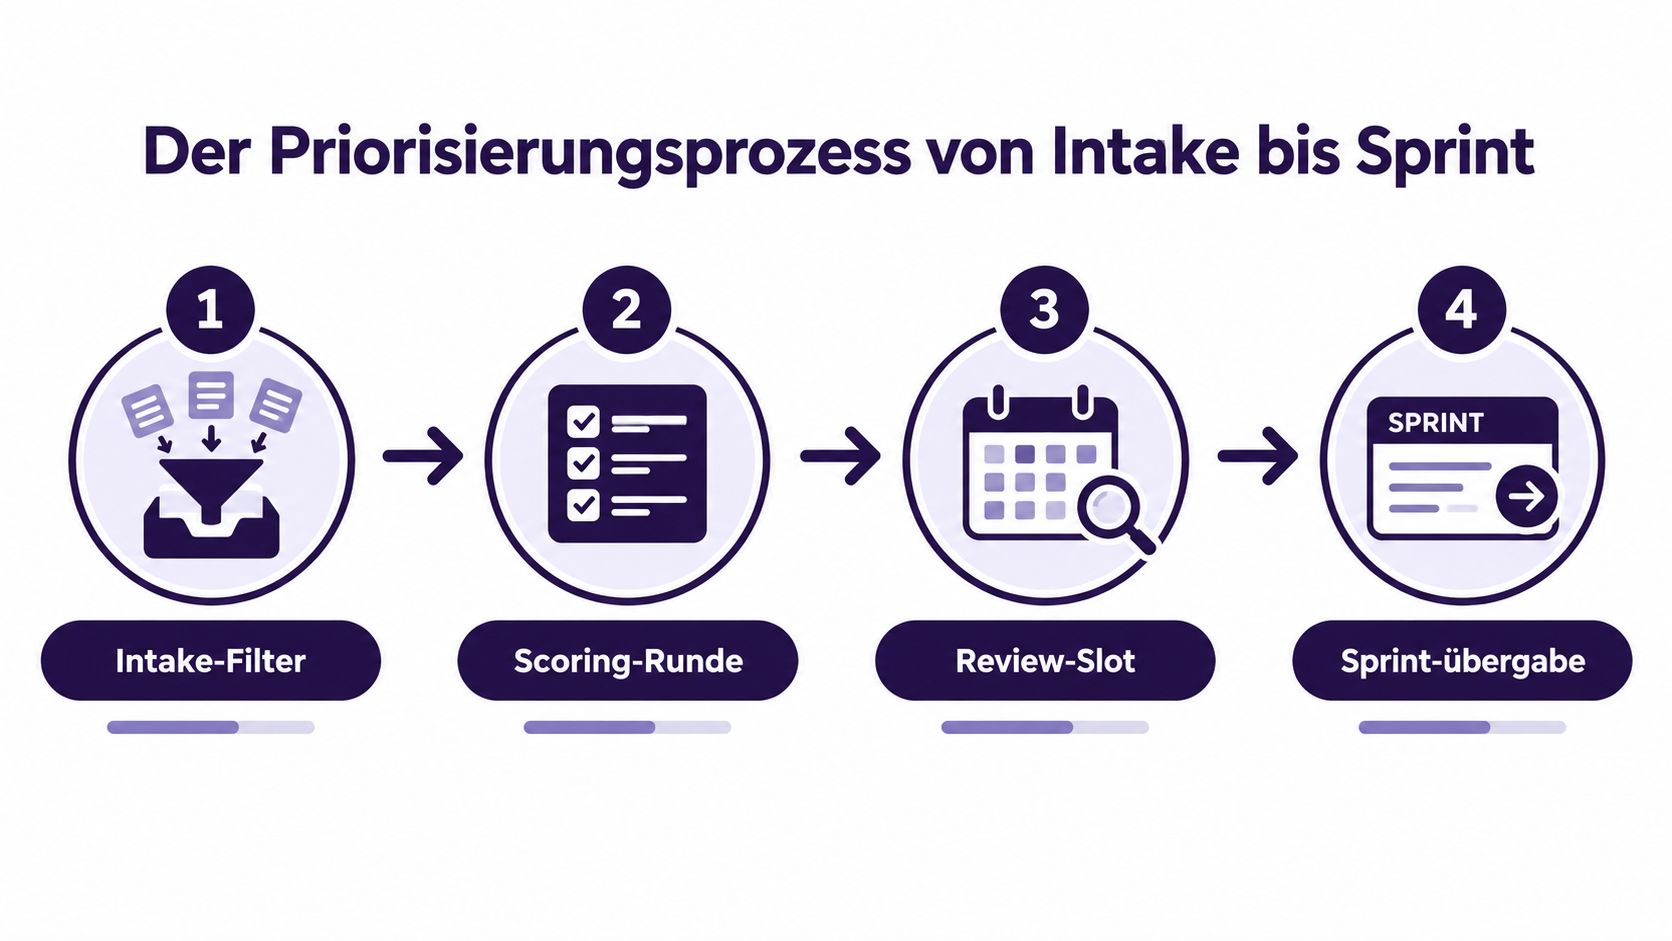
Jede Station braucht ein Artefakt und ein Zeitfenster. Der Intake erzeugt einen prüfbaren Eintrag, das Scoring eine begründete Bewertung, der Review eine Entscheidung und die Sprint-Übergabe ein umsetzbares Arbeitspaket. So entsteht ein laufender Workflow statt eines Meetings, in dem alle Probleme gleichzeitig gelöst werden sollen.
Bei verteilten Teams sollte dieser Ablauf in einem gemeinsam einsehbaren System abgebildet werden. Jira Advanced Roadmaps kann dabei eine technische Grundlage sein, die eigentliche Governance bleibt jedoch bei den Verantwortlichen.
Die Sprint-Übergabe sollte ausserdem ein klares Pull-Kriterium enthalten. Dazu gehören ausreichender Kontext, bekannte Abhängigkeiten, akzeptierte Annahmen und eine verständliche Definition of Done. Wer diese Prüfung auslässt, verschiebt die Priorisierungsarbeit nur in die Entwicklung.
Vor dem Video lohnt sich die Frage, ob der eigene Ablauf tatsächlich vier getrennte Entscheidungen kennt oder nur ein langes Statusmeeting ist.
Viele Teams behaupten, ihr Backlog sei priorisiert. Häufig ist lediglich eine Reihenfolge eingetragen. Das reicht nicht. Ein priorisiertes Item muss so gut verstanden sein, dass das Team seine Position gegen andere Items verteidigen kann.
DEEP bündelt dafür vier Eigenschaften: Detailed appropriately, Estimated, Emergent und Prioritized. Die ersten drei schaffen die Voraussetzung für das P. Ein vages Item kann nicht sinnvoll bewertet werden. Ein nicht geschätztes Item kann nicht mit einem anderen Aufwand verglichen werden. Ein statisches Backlog kann keine neuen Erkenntnisse aufnehmen.
Die praktische Bedeutung von DEEP ist einfach: Oben stehen die detailliertesten und am besten verstandenen Items. Weiter unten dürfen Einträge gröber bleiben. Die DEEP-Erklärung für Backlog Grooming beschreibt genau dieses Prinzip, bei dem höhere Priorität mit höherem Detailgrad, Schätzung und Umsetzungsnähe einhergeht.
Stories ohne Akzeptanzkriterien sind keine guten Kandidaten für die Spitze. Grosse Epics gehören nicht in die unmittelbare Sprint-Nähe, wenn niemand sie in umsetzbare Einheiten zerlegt hat. Schätzungen, die niemand begründen kann, erzeugen keine Sicherheit, sondern nur eine Zahl im System.
Ein funktionierender Refinement-Mechanismus braucht deshalb feste Regeln:
Ein fünfköpfiges Engineering-Team kann dafür pro Sprint 4 bis 6 Stunden Refinement einplanen, sofern diese Angabe als konkrete Teamvereinbarung verstanden wird und nicht als allgemeingültiger Benchmark. Entscheidend ist nicht die exakte Stundenzahl, sondern dass Refinement sichtbar budgetiert wird. Eine Stunde zwischen Tür und Angel reicht selten für ein Backlog, das tatsächlich planbar sein soll.
Verteilte Teams verändern nicht das Ziel der Priorisierung, aber die Mechanik. Gespräche können nicht jederzeit spontan stattfinden. Kontext geht verloren, wenn Entscheidungen nur in Videocalls fallen. Externe Senior-Entwickler können fachlich sehr stark sein und trotzdem an einem fehlenden Übergabeartefakt scheitern.
Drei Hebel bestimmen die Qualität: Timezone-Overlap, Artefaktqualität und Übergabedisziplin. Das Team braucht ein gemeinsames Scoring-Sheet, kurze schriftliche Refinement-Threads und eine Handover-Notiz für jedes Sprint-Item. Diese Notiz enthält Kontext, Annahmen, bekannte Risiken und explizite Out-of-Scope-Punkte.
Der Product Owner nimmt zunächst ein Grob-Scoring vor. Der externe Engineer prüft danach technische Machbarkeit, Abhängigkeiten, Integrationsrisiken und die vorgeschlagene Zerlegung. Erst wenn beide Perspektiven vorliegen, wird das Item für die Sprint-Übergabe freigegeben.
Das verhindert zwei typische Fehler. Erstens bewertet der Product Owner technische Komplexität aus dem Bauch heraus. Zweitens übernimmt der externe Entwickler stillschweigend Produktentscheidungen, weil die fachliche Priorität nicht dokumentiert wurde.
| Hebel | Co-located | Verteilt mit externen Senior-Devs |
|---|---|---|
| Timezone-Overlap | Spontane Rückfragen sind möglich | Gemeinsame Kernzeiten und Antwortfristen definieren |
| Entscheidungslogik | Kann im Workshop erklärt werden | Scoring-Felder und schriftliche Begründung verpflichtend machen |
| Refinement | Gemeinsames Gespräch mit direkter Klärung | Asynchrone Vorarbeit, danach fokussierter Review |
| Übergabe | Kontext liegt teilweise im Teamgedächtnis | Handover-Note mit Annahmen und Out-of-Scope-Punkten |
| Technischer Review | Engineering Lead prüft direkt | Externer Senior-Engineer prüft vor der Zusage |
| KI-Unterstützung | Entwürfe können im Gespräch korrigiert werden | KI erzeugt Item-Skelette aus Notizen, ein Mensch bestätigt jede Annahme |
KI kann in diesem Setup erste Item-Skelette aus Stakeholder-Notizen erstellen, Begriffe vereinheitlichen oder fehlende Fragen markieren. Sie darf aber weder die technische Schätzung als Tatsache ausgeben noch die Reihenfolge eigenständig verändern. Ein Modell kennt den impliziten Kontext eines Kundenversprechens oder einer regulatorischen Abhängigkeit oft nicht.
Verteilte Priorisierung funktioniert nicht mit mehr Meetings. Sie funktioniert mit besseren Artefakten.
Der CTO sollte ausserdem klären, welche Daten externe Beteiligte sehen dürfen. Kundenidentitäten, personenbezogene Nutzungsdaten und vertrauliche Vertragsinhalte gehören nicht unkontrolliert in ein Modell oder einen offenen Chat. Das betrifft nicht nur Datenschutz, sondern auch die Nachvollziehbarkeit späterer Entscheidungen.
CTOs brauchen kein Dashboard voller Aktivitätszahlen. Sie brauchen wenige Kennzahlen, die zeigen, ob Prioritäten in umsetzbare Arbeit übersetzt werden. Die passende Perspektive ist der Weg von der Idee bis zum Deployment, ergänzt um Stabilität und Entscheidungsqualität. Für die Auswahl und Interpretation von Kennzahlen bietet KPI- und Business-Intelligence-Orientierung einen sinnvollen Kontext.
Ergänzend helfen Carry-Over-Rate und Story-Split-Frequenz. Carry-over zeigt, ob das Team regelmässig zu viel verspricht. Story-Splits zeigen, ob die ursprüngliche Zerlegung zu gross oder zu unklar war.
| Metrik | Definition | Schwellenwert | Steuerungsimpuls |
|---|---|---|---|
| Lead Time for Changes | Idee bis Deployment | Trend über mehrere Sprints | Warteschlangen und Abhängigkeiten prüfen |
| Throughput | Abgeschlossene Items je Team und Sprint | Nicht isoliert bewerten | Item-Grösse und Qualität kontrollieren |
| Re-Priorisierungs-Rate | Neu sortierte Items im Beobachtungsfenster | Dauerhaft hoch ist ein Warnsignal | Annahmen, Governance und Intake überprüfen |
| Refinement-Investment-Ratio | Refinement im Verhältnis zu Engineering | Zu niedrig oder stark steigend | Refinement-Kadenz und Item-Qualität justieren |
| Carry-over-Rate | Nicht abgeschlossene Sprint-Items | Wiederkehrendes Carry-over | Kapazität und Pull-Kriterium schärfen |
| Story-Split-Frequenz | Nachträgliche Aufteilung gestarteter Items | Häufige Splits | Definition of Ready und Decomposition verbessern |
Das Steering-Board braucht daraus keine lange Präsentation. Ein kurzer Review pro Sprint reicht, wenn jede Abweichung eine konkrete Frage auslöst: Welche Annahme war falsch? Wer entscheidet über die Anpassung? Welches Backlog-Artefakt wird geändert?
KI eignet sich gut als Assistent, schlecht als Product Owner. Sie kann Stakeholder-Notizen strukturieren, fehlende Felder markieren, ähnliche Items erkennen und vorhandene Daten für ein Scoring aufbereiten. Die letzte Entscheidung über Reihenfolge, Risikoakzeptanz und Scope bleibt beim verantwortlichen Menschen.
Gerade im deutschen Umfeld ist die Datenbasis entscheidend. Aktuelle deutschsprachige Fachtexte aus 2026 diskutieren KI als Unterstützung für die Auswertung von Nutzerverhalten, Markttrends und Teamkapazität, während der Product Owner die Entscheidung behält. Die Diskussion zur Rolle des Product Owners im KI-Zeitalter verweist damit auf die zentrale Governance-Frage: Wer prüft Daten, Bias, Aktualität und Zweckbindung?
Verarbeitet werden sollten nur Daten, deren Zweck, Zugriff und Aufbewahrung geklärt sind. Personenbezogene Informationen, vertrauliche Kundendetails und sensible Vertragsdaten gehören nicht ungeprüft in externe Modelle. Historische Sprintdaten können ausserdem bestehende Verzerrungen reproduzieren. Wenn ein Team bestimmte Arten von Arbeit früher systematisch unterschätzt hat, kann ein Modell diesen Fehler fortschreiben.
Die sichere Kette lautet: Modell erzeugt Vorschlag, Product Owner prüft Kontext, Engineering validiert Aufwand und Risiko, Entscheidung wird mit Begründung protokolliert. Bei widersprüchlichen Signalen darf der Mensch den Vorschlag verwerfen. Ein Audit-Log sollte festhalten, welche Daten verwendet wurden, welche Empfehlung entstand und wer die endgültige Entscheidung getroffen hat.
Für weiterführende Perspektiven auf digitale Arbeitsweisen und verwandte Fachthemen lohnt sich eine kuratierte Übersicht der Blogartikel. Sie ersetzt keine interne Governance, kann aber helfen, neue Fragen für die eigene Praxis zu identifizieren.
Beantworte die Fragen in dieser Reihenfolge. Beginne mit dem Punkt, bei dem die Antwort zuerst „Nein“ lautet.
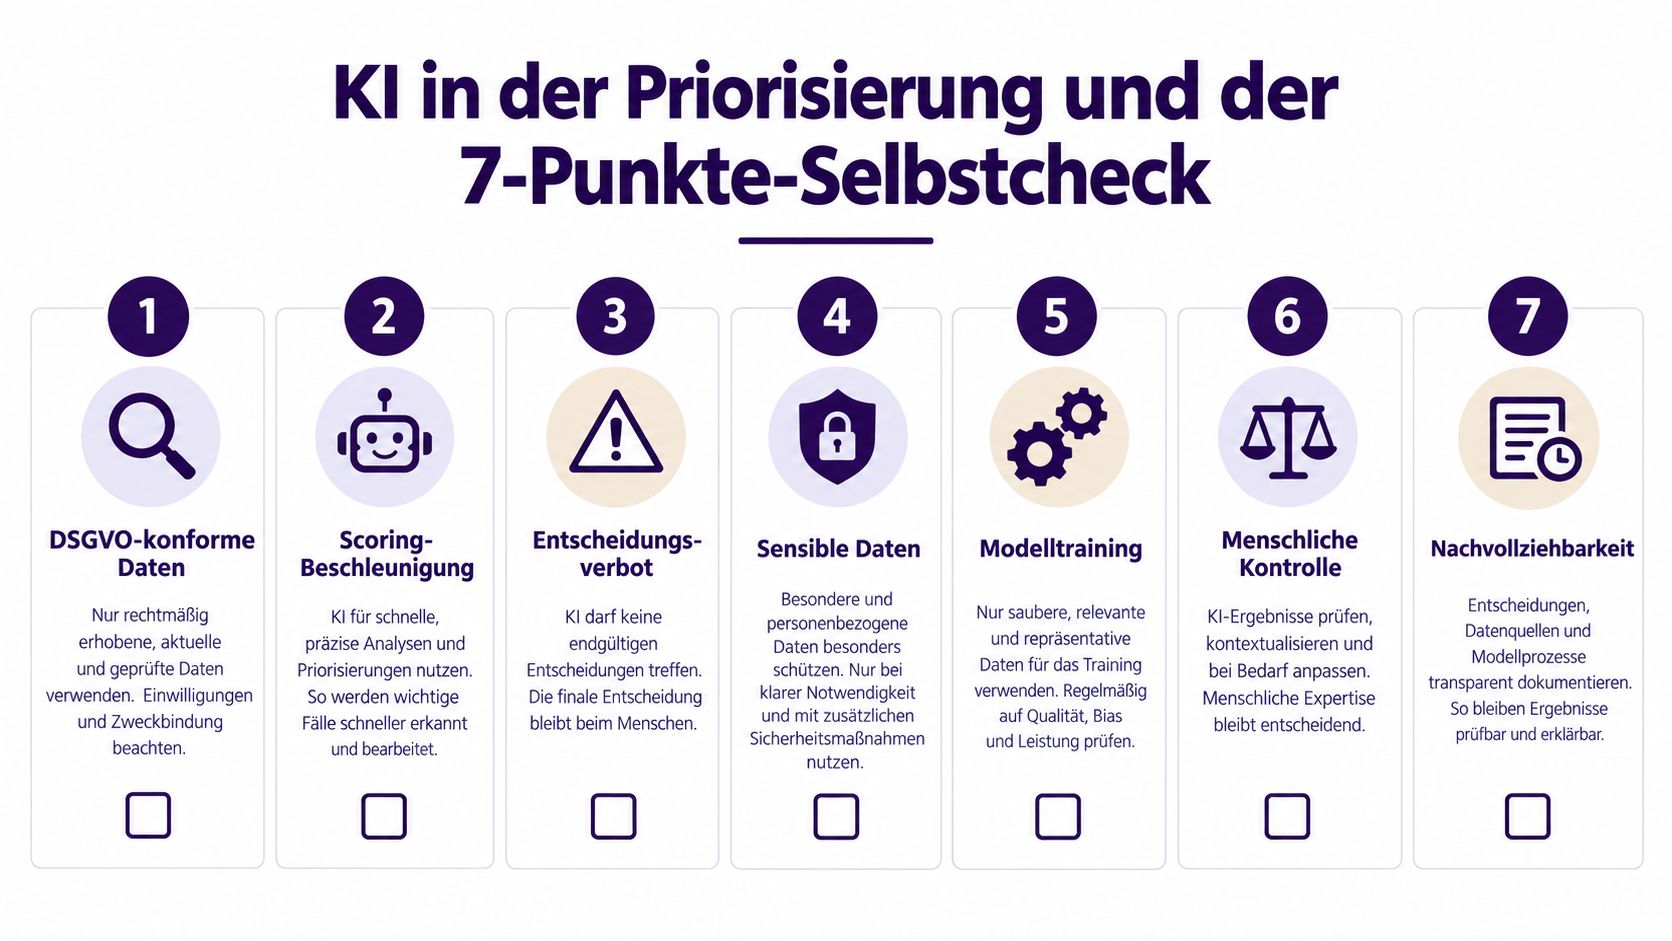
Wenn Punkt eins oder drei scheitert, bringt zusätzliche KI wenig. Wenn Punkt vier oder fünf scheitert, wird verteilte Zusammenarbeit teuer durch Rückfragen und Missverständnisse. Beginne dort, wo eine kleine Prozessänderung sofort mehrere nachgelagerte Entscheidungen verbessert.
PandaNerds unterstützt Unternehmen dabei, Backlog-Entscheidungen mit sorgfältig ausgewählten Senior-Entwicklern, klaren Übergaben und flexibler Teamverstärkung in umsetzbare Lieferpläne zu übersetzen. Besprich deine Priorisierungs- und Engineering-Herausforderungen mit PandaNerds und kläre, welche Senior-Kompetenz dein Team für den nächsten belastbaren Sprint braucht.