02.07.2025
Asana vs. Trello: Welches Projektmanagement-Tool ist besser?
Asana vs. Trello: Welches Projektmanagement-Tool ist besser? Wir vergleichen beide Tools im Projektmanagement. Welches Tool passt besser zu Ihren Zielen?
get started


Ein Deployment kann lokal sauber aussehen und trotzdem beim Rollout scheitern. Die Anwendung startet, der Health Check bleibt grün, doch eine fehlende Datenbankmigration, ein anderes Betriebssystempaket oder eine abweichende Konfiguration legt einen zentralen Workflow lahm. Dann wird aus einem normalen Release eine nächtliche Incident-Schicht.
Genau hier kommt eine Staging Environment ins Spiel. Sie ist keine zusätzliche Bürokratiestufe, sondern eine kontrollierte Generalprobe zwischen Entwicklung und Produktivbetrieb. Richtig aufgebaut, schützt sie Nutzer, Reputation und Umsatz. Falsch aufgebaut, erzeugt sie vor allem laufende Kosten, Datenschutzrisiken und ein trügerisches Sicherheitsgefühl.
Ein Team entwickelt eine neue Zahlungslogik. Die Unit-Tests laufen durch, die lokale Anwendung funktioniert, und die Änderung geht direkt in Produktion. Erst dort zeigt sich, dass die Datenbankversion abweicht oder ein Konfigurationswert fehlt. Der Code war nicht zwingend falsch. Der Ausführungskontext war es.
Solche Fehler entstehen an Übergängen. Entwicklungsumgebungen optimieren Geschwindigkeit und enthalten häufig vereinfachte Daten, lokale Services sowie individuelle Einstellungen. Produktion arbeitet dagegen mit realen Integrationen, strengeren Berechtigungen, anderen Netzwerkpfaden und gewachsenen Datenstrukturen. Ohne eine produktionsnahe Zwischenstation bleibt dieser Teil des Releases ungeprüft.
Eine Staging Environment bildet den späteren Betrieb möglichst realitätsnah ab, bleibt aber von echten Nutzern und produktiven Daten getrennt. Dort prüft das Team End-to-End-Abläufe, Konfigurationsänderungen, Datenbankmigrationen und Integrationen, bevor ein Release freigegeben wird. AWS beschreibt Staging als Replikat des Produktionssystems, in dem zusätzliche Funktionstests vor dem Go-live stattfinden, einschliesslich IaC-Deployment und Datenbank-Versionierung (AWS-Leitfaden zu Staging-Umgebungen).
Der Nutzen entsteht durch gezielte Risikosimulation, nicht durch eine blinde Kopie jeder Produktionskomponente:
Jede produktionsnahe Kopie erzeugt allerdings laufende Infrastrukturkosten und zusätzliche Angriffsflächen. Werden Testdaten aus Produktion übernommen, kommen Datenschutzpflichten hinzu. Personenbezug muss entfernt oder wirksam maskiert werden, Zugriffe brauchen klare Zuständigkeiten, und nicht mehr benötigte Umgebungen sollten automatisch verschwinden. Für kurzfristige Feature-Prüfungen kann ein Ephemeral Staging sinnvoller sein. Persistentes Staging passt besser zu wiederkehrenden Abnahmen, langen Migrationstests und stabilen Integrationen.
Eine Staging Environment verhindert nicht jeden Fehler. Sie verlagert kritische Erkenntnisse aus der Live-Situation in einen kontrollierten Prozess. Das Team bewertet dadurch nicht nur Code, sondern ein deploybares Gesamtsystem.
"Praktische Regel: Wird ein Fehler erst in Produktion sichtbar, prüfen Sie zuerst die Differenz zwischen den Umgebungen. Nicht jede Ursache liegt im Anwendungscode."
Für deutsche Unternehmen ist die Trennung auch institutionell abgesichert. Das BSI fordert im Grundschutz-Kompendium 2023 eine eigenständig betriebene Testumgebung, getrennt von der Produktivumgebung. OPS.1.1.6.A13 verlangt ausdrücklich diese Trennung und eine möglichst repräsentative Abdeckung der eingesetzten Gerätemodelle und Betriebssystemumgebungen (BSI, OPS.1.1.6 Software-Tests und Freigaben). Staging ist damit ein kontrollierter Bestandteil sicherer Softwarefreigaben.
Development, QA und Staging lösen unterschiedliche Probleme. Wer alle drei Umgebungen gleich behandelt, bezahlt oft für Infrastruktur, ohne die Testqualität zu erhöhen.
Development ist der Arbeitsbereich der Entwickler. Dort entstehen Codeänderungen, Unit-Tests und frühe Integrationsprüfungen. Geschwindigkeit zählt mehr als vollständige Produktionsnähe. Lokale Container, Mock-Services und vereinfachte Seed-Daten sind sinnvoll, solange niemand daraus eine Freigabeaussage ableitet.
QA konzentriert sich auf die funktionale Qualität einzelner Features und klar definierter Testfälle. Automatisierte Regressionstests, manuelle Prüfungen und reproduzierbare Fehlerszenarien gehören hierher. QA darf bewusst kontrollierter oder kleiner als Produktion sein, wenn das den Testzweck unterstützt.
Staging ist die finale Generalprobe. Die getestete Anwendung wird mit einer produktionsnahen Infrastruktur, vergleichbaren Integrationen und realistischen, datenschutzkonformen Daten geprüft. Hier geht es nicht nur um die Frage, ob ein Feature funktioniert, sondern ob der geplante Release unter den Bedingungen des späteren Betriebs sicher ausgerollt werden kann.
Production verarbeitet echte Nutzeraktionen und geschäftskritische Daten. Dort sind Experimente fehl am Platz. Änderungen sollten aus einem geprüften Artefakt promoted werden, nicht aus einem spontan neu gebauten Paket.
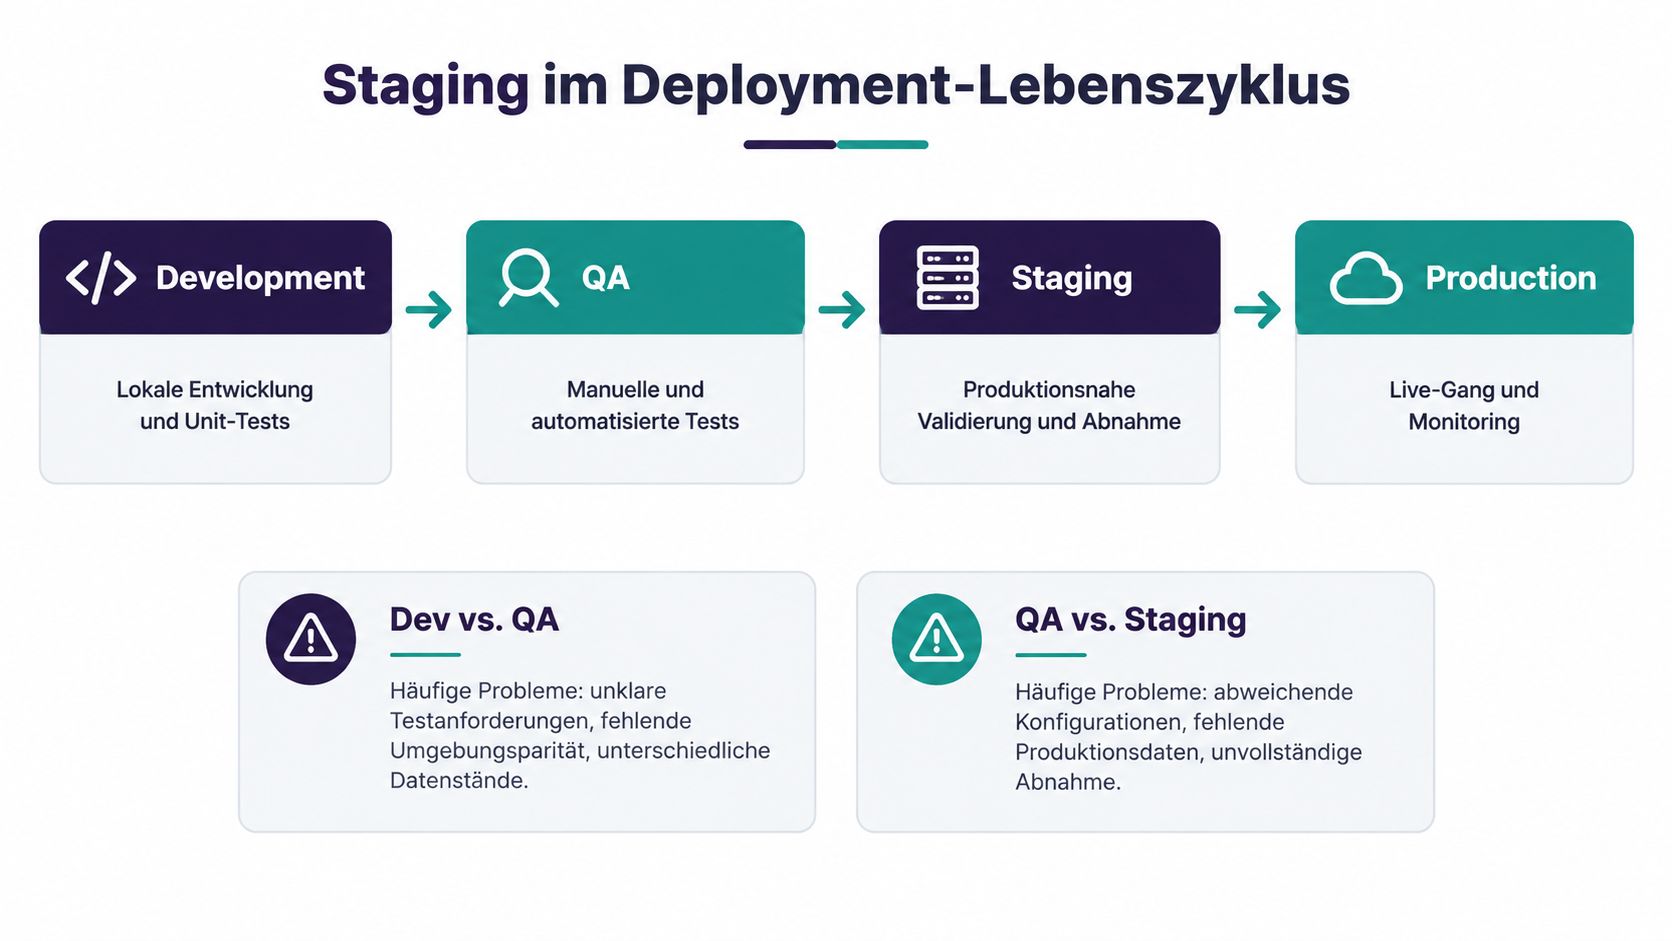
Ein QA-System kann einen Fehler in einer isolierten Funktion finden. Staging zeigt, ob diese Funktion mit Authentifizierung, Datenbank, Queues, Observability und externen Diensten zusammenarbeitet. Diese Abgrenzung verhindert eine häufige Fehlentscheidung: Ein Team erklärt einen grünen QA-Report zum Produktionsfreigabesignal, obwohl die Deployment-Skripte oder Infrastrukturänderungen nie produktionsnah geprüft wurden.
Für Teams, die ihre Testprozesse systematisch aufbauen, bietet die Qualitätssicherung für skalierbare Lösungen von ARIT Services GmbH einen passenden Referenzpunkt. Entscheidend ist nicht die Anzahl der Testfälle, sondern ihre Zuordnung zur richtigen Umgebung und zur jeweiligen Freigabefrage.
Das BSI verschärft diese Sichtweise. Die Testumgebung soll nicht nur getrennt betrieben werden, sondern möglichst alle relevanten Gerätemodelle und Betriebssystemumgebungen repräsentieren. Für CTOs bedeutet das: Die Staging-Frage gehört in die Architektur- und Risikoplanung, nicht erst in die Diskussion vor dem Release.
Ein sauberer Lebenszyklus nutzt dieselben Build-Artefakte über die Stufen hinweg. Die Umgebung darf sich unterscheiden, die getestete Binärdatei oder der Container sollte es nicht. Dadurch prüft das Team tatsächlich das Artefakt, das später in Produktion läuft.
Eine Staging Environment zeigt nur dann relevante Fehler, wenn ihre Architektur die problematischen Eigenschaften von Production abbildet. Vollständige Gleichheit verursacht jedoch hohe Infrastruktur-, Betriebs- und Datenschutzkosten. Entscheidend ist daher, welche Eigenschaften für die Risikoklasse des Systems unverzichtbar sind und welche Unterschiede vertretbar bleiben.
Virtuelle Maschinen passen zu monolithischen Anwendungen, älterer Middleware und Teams, die ihre Betriebsumgebung bereits VM-basiert verwalten. Sie bilden Betriebssystem, Laufzeit und Netzwerk nachvollziehbar ab. Der Preis ist laufende Pflege: Patches, Images und manuelle Konfigurationen erzeugen Drift und binden Betriebskapazität.
Docker-Container sind sinnvoll, wenn Production bereits containerisiert ist oder ein reproduzierbares Build- und Deployment-Modell benötigt wird. Derselbe Container kann durch QA, Staging und Production laufen, während umgebungsspezifische Einstellungen getrennt bleiben. Container lösen jedoch weder Datenbank-Parität noch Netzwerkregeln oder Abhängigkeiten zu externen Services.
Kubernetes rechtfertigt den zusätzlichen Aufwand, wenn Production auf Kubernetes läuft und Releases durch Orchestrierung, Autoscaling, Ingress, Secrets oder mehrere Services riskant werden. Ein vereinfachtes lokales Cluster prüft zwar Anwendungscode, bildet aber Produktionsrichtlinien, Scheduling und Netzwerkressourcen nicht zuverlässig ab. Für diese Fälle muss Staging dieselben zentralen Mechanismen verwenden, auch wenn die Kapazität kleiner ausfällt.
AWS beschreibt produktionsnahe Staging-Replikate, Infrastructure as Code, versionierte Datenbankschemata und reproduzierbare Deployments als Grundlage für Integrations- und Lasttests (AWS beschreibt produktionsnahe Staging-Replikate und IaC-Prüfungen). Eine manuell veränderte Umgebung verschiebt die Fehlerquelle von der Anwendung in die Infrastruktur. Für Teams bedeutet das zusätzliche Fehlersuche und ein erhöhtes Risiko, dass ein Release nur wegen einer nicht dokumentierten Konfiguration funktioniert.
Repository und Plattformdefinition sollten deshalb dieselben Module für Staging und Production verwenden. Unterschiede werden bewusst als Parameter modelliert:
Für Cloud-Architekturen ist das Netzwerk ein eigener Prüfbereich. Google empfiehlt gespiegelte Netzwerkdesigns für Test- und Produktionsumgebungen sowie konsistente CI/CD-Pipelines, die dieselben Binärdateien, Pakete oder Container ausliefern (Google Cloud zu gespiegelten Netzwerkdesigns und konsistenten Artefakten). Direkte Kommunikation zwischen Umgebungen sollte ausgeschlossen werden. Separate Netzdomänen, getrennte Service Accounts und explizite Egress-Regeln schützen dabei nicht nur Production, sondern begrenzen auch den Schaden bei kompromittierten Testzugängen.
Eine sinnvolle Optimierung reduziert Betriebsdauer und Kapazität, nicht die zu prüfende Architektur. Ein kleineres, dauerhaftes Staging-Cluster kann funktionale Tests abdecken. Für Performance- oder Migrationstests wird dieselbe Struktur zeitweise auf die benötigte Grösse skaliert und danach wieder abgeschaltet. Ephemeral Staging passt zu kurzen, klar abgegrenzten Testläufen. Persistent Staging bleibt sinnvoll, wenn externe Abnahmen, lange Regressionen oder manuelle Freigaben eine stabile Adresse und dauerhafte Datenbasis benötigen.
Cloud-Architekturen und ihre Betriebsmodelle werden bei Cloud nativ einfach erklärt verständlich eingeordnet. Für die konkrete Wahl zählt dennoch der Produktionsstack. Kubernetes-Staging ist nicht automatisch sinnvoll, wenn die Anwendung später auf VMs läuft. Ein Container-Setup simuliert zudem kein komplexes Cluster, wenn Scheduling, Netzwerk oder Plattformrichtlinien den eigentlichen Release-Risikopunkt bilden.
Die riskanteste Abkürzung beim Aufbau einer Staging Environment ist oft ein Datenbankdump aus Production. Er fühlt sich effizient an, weil sofort realistische Datensätze vorhanden sind. Gleichzeitig wandern damit möglicherweise personenbezogene Daten, interne Notizen, Tokens oder geschäftskritische Informationen in eine Umgebung, die mehr Entwickler und weniger strenge Zugriffskontrollen hat.
Der BfDI hält fest, dass Testdaten mit Personenbezug im Regelfall vermeidbar sind. Werden stattdessen nicht-personenbezogene Daten verwendet, greifen die DSGVO-Vorgaben für diese Daten nicht in gleicher Weise. Diese Position macht Datenminimierung zu einer Architekturentscheidung, nicht zu einer nachträglichen Compliance-Prüfung (Einordnung des BfDI zu Datenschutz bei Softwareentwicklung).
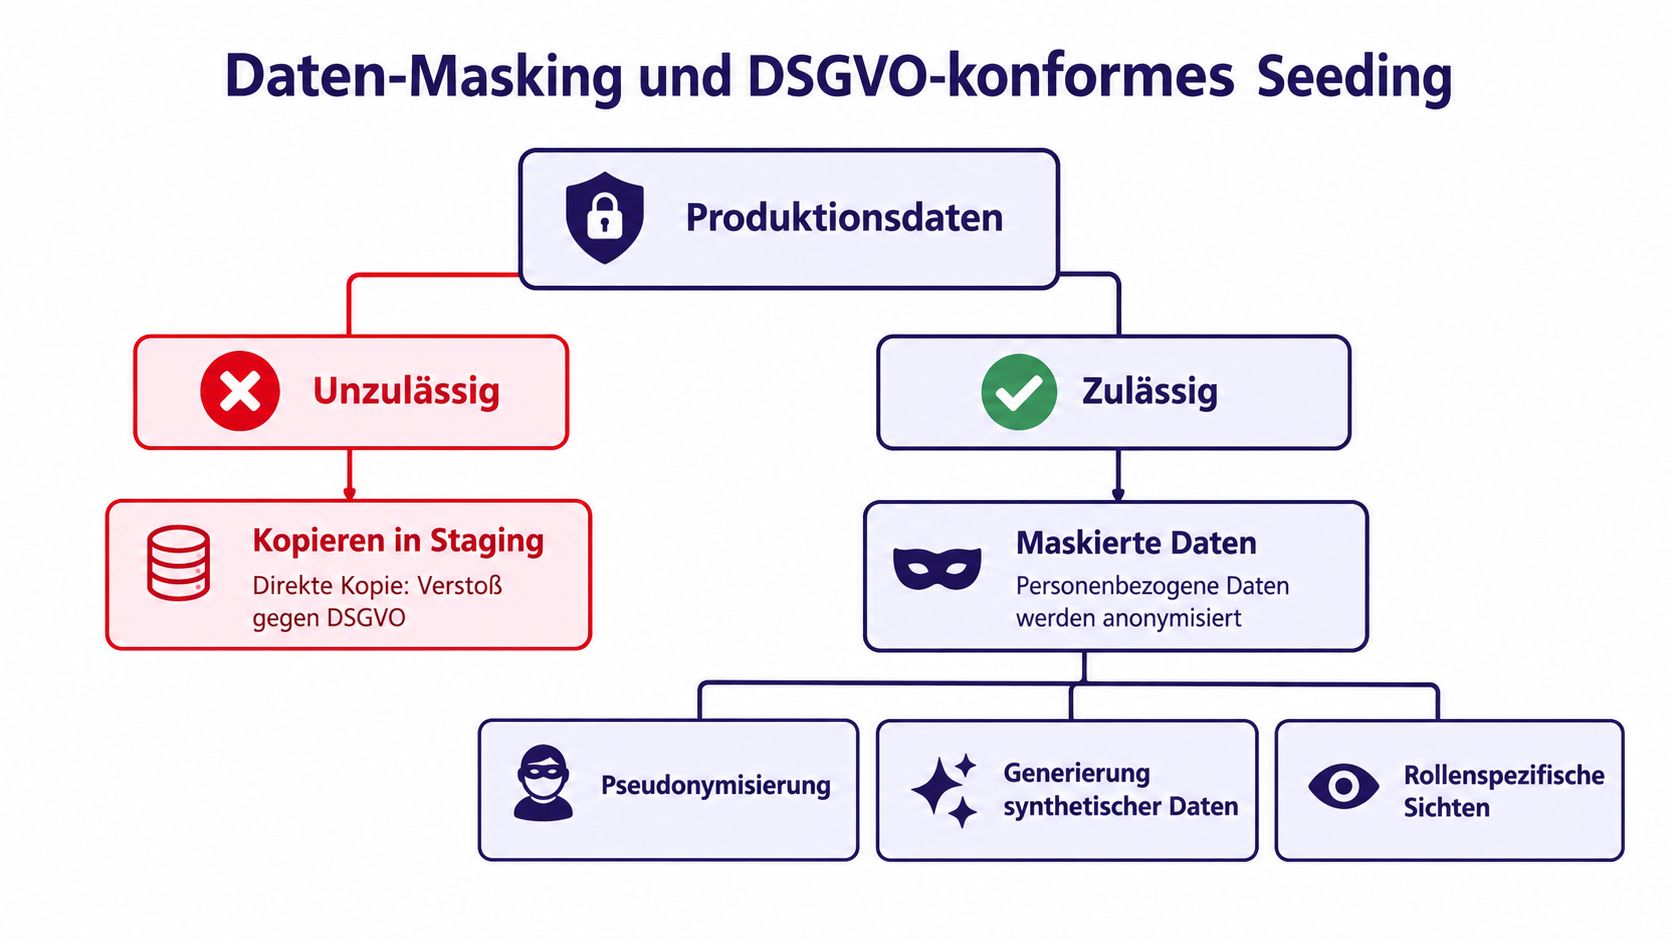
Vollständige Produktionskopien sind für Staging meist die schlechteste Standardeinstellung. Sie erhöhen das Risiko, erschweren Lösch- und Zugriffsprozesse und machen jede weitere Umgebung zu einem potenziellen Datenschutzproblem. Rein synthetische Daten sind dagegen nicht immer ausreichend. Sie können Fehler bei Migrationen, Rollenrechten, Sonderzeichen, Datenverknüpfungen oder realistischen Lastmustern verdecken.
Ein belastbares Modell arbeitet mit Datenklassen:
Der wichtigste Schritt ist die Klassifizierung vor dem Export. Das Team listet Tabellen und Felder auf, markiert Personenbezug, Geheimnisse und besonders schützenswerte Informationen und definiert anschliessend je Feld eine Maskierungsregel. E-Mail-Adressen werden beispielsweise in nicht zustellbare Testwerte überführt, Namen durch konsistente Platzhalter ersetzt und freie Textfelder entfernt oder synthetisch generiert.
Ein einmaliger manueller Maskierungslauf ist kein Prozess. Bei jedem Refresh können neue Spalten, Integrationen oder Datenpfade hinzukommen. Ohne automatisierte Prüfungen bleibt unklar, ob die Regeln noch vollständig sind.
Ebenso problematisch ist die Annahme, eine pseudonymisierte Kennung sei automatisch anonym. Wenn ein Team die Zuordnung wiederherstellen kann oder zusätzliche Quellen eine Person identifizierbar machen, bleibt das Datenschutzrisiko bestehen. Datenschutzbeauftragte sollten deshalb früh in die Definition der Datenklassen und Zugriffskonzepte eingebunden werden.
"Datenregel: Je realistischer die Testdaten sein müssen, desto genauer muss das Team begründen, warum synthetische oder anonymisierte Varianten nicht ausreichen."
Für CTOs gehört diese Entscheidung in die Release-Architektur. Eine Übersicht zu Compliance-Anforderungen kann dabei helfen, technische und organisatorische Anforderungen gemeinsam zu betrachten. Das Ziel ist nicht, jede realistische Information in Staging zu bringen. Das Ziel ist, genau die Datenmerkmale zu reproduzieren, die für den Test relevant sind, und den Rest konsequent wegzulassen.
Ein guter Testdatensatz besitzt deshalb Strukturtreue ohne Personenbezug. Er enthält gültige Beziehungen, Grenzfälle, fehlerhafte Zustände und realistische Rollenmodelle, aber keine unnötigen identifizierbaren Datensätze. Diese Trennung reduziert Risiko und macht den Refresh-Prozess wiederholbar.
Eine Staging Environment bringt wenig, wenn Entwickler sie per Hand aktualisieren und niemand weiss, welcher Commit gerade geprüft wird. Der Release-Prozess muss nachvollziehbar sein: Code wird gebaut, als unveränderliches Artefakt abgelegt, in Staging ausgerollt, getestet und erst danach zur Promotion freigegeben.
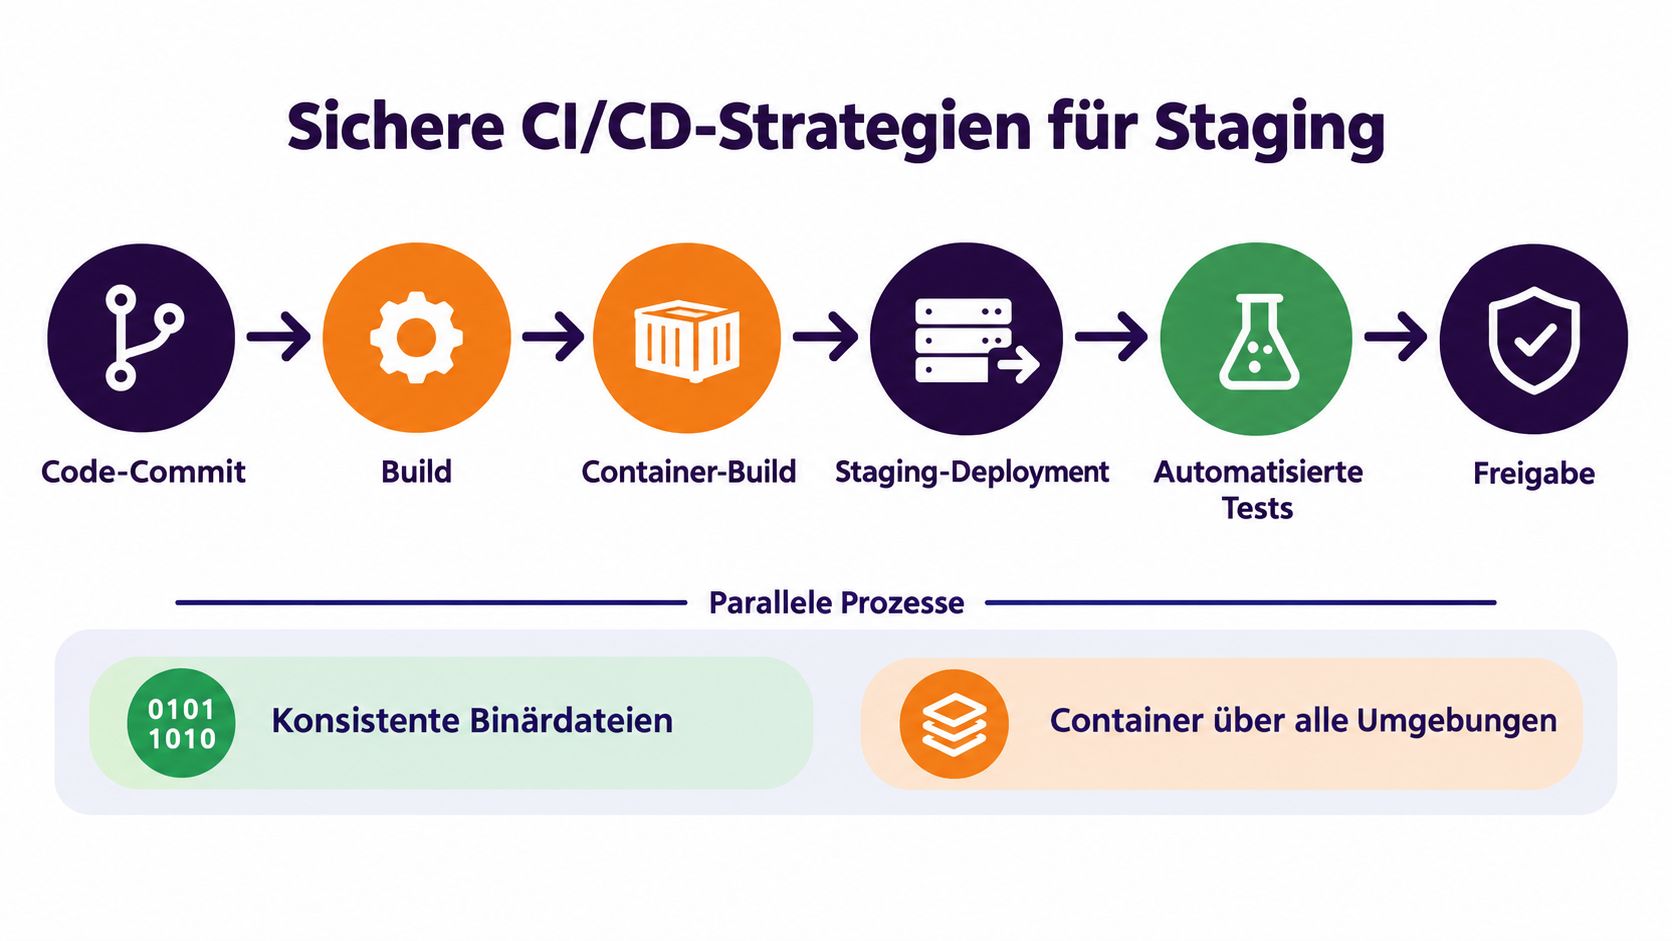
Die Pipeline sollte den Build einmal erzeugen und dasselbe Paket oder denselben Container durch Development, QA, Staging und Production bewegen. Ein erneuter Build vor dem Produktivgang kann eine andere Abhängigkeit, ein anderes Basisimage oder eine andere Compilerumgebung verwenden. Dann wurde in Staging nicht das Artefakt geprüft, das später live läuft.
Ein praktikabler Ablauf sieht so aus:
Die Trennung von Build, Test und Promotion hält den Prozess schnell und auditierbar. Für Teams, die CI-Grundlagen und Automatisierung sauber einordnen möchten, bietet der Beitrag Was ist Continuous Integration eine passende technische Orientierung.
Ein manueller Approval Gate ist kein zweiter Klick ohne Bedeutung. Die verantwortliche Person braucht einen kompakten Nachweis: Was wurde geändert, welche Tests liefen, welche Daten wurden verwendet, welche Risiken sind offen und wie sieht der Rückweg aus? Wenn diese Informationen fehlen, wird die Freigabe zur Formalität.
Zugriffskontrollen gehören ebenfalls in die Pipeline. Nur definierte Rollen dürfen Staging-Daten aktualisieren, Freigaben erteilen oder eine Promotion starten. Service Accounts erhalten minimale Rechte und verwenden umgebungsspezifische Secrets. Direkte Änderungen auf Servern werden verhindert oder zumindest vollständig protokolliert.
Monitoring darf nicht erst in Production beginnen. Staging sollte Logs, Metriken und Traces erfassen, damit das Team Fehlerbilder erkennt, bevor ein Release live geht. Dabei genügt es nicht, nur technische Health Checks zu prüfen. Ein kritischer Geschäftsworkflow muss ebenfalls sichtbar werden, etwa ein Login, ein Auftrag oder eine Datenverarbeitung.
Die Cenedril-Richtlinie fordert, Änderungen vor Production in Test oder Staging zu prüfen und Testnachweise mit dem Change-Record zu verbinden (Richtlinie zu Deployment-Umgebungen und Freigaben). Dieser Nachweis schützt nicht nur bei Audits. Er verhindert auch, dass ein Team Monate später rätseln muss, welche Version unter welchen Bedingungen freigegeben wurde.
Eine permanente Staging Environment wirkt zunächst wie die sichere Standardlösung. In der Praxis läuft sie jedoch oft auch dann, wenn niemand testet. Datenbanken altern, Images werden nicht aktualisiert, Zertifikate und Testaccounts verfallen, und Plattformteams pflegen eine Umgebung, die nur sporadisch genutzt wird.
Die Alternative ist nicht, Staging abzuschaffen. Sie besteht darin, zwischen dauerhafter Produktionsabnahme und kurzlebiger Änderungsprüfung zu unterscheiden.
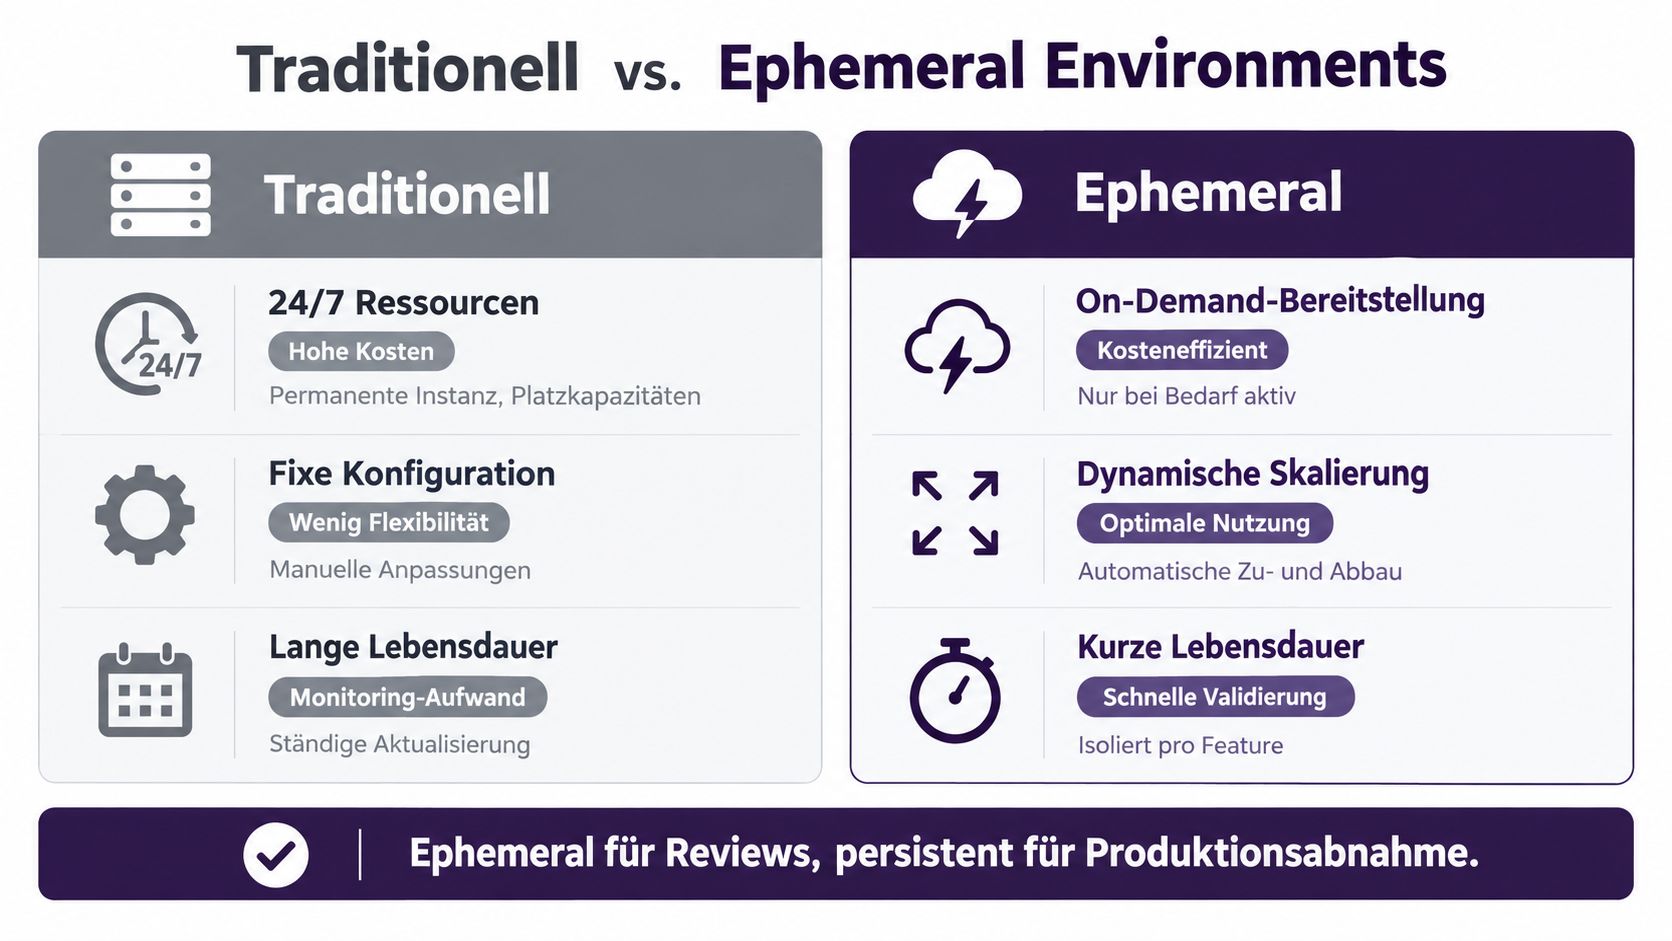
Persistent Staging eignet sich für Releases, die eine stabile Abnahme durch Fachbereiche, wiederkehrende End-to-End-Tests oder kontrollierte Performanceprüfungen brauchen. Auch Systeme mit komplexen Integrationen profitieren von einem festen Referenzpunkt. Die Kosten liegen nicht nur in Compute-Ressourcen. Hinzu kommen Datenpflege, Monitoring, Patchen, Zugriffsverwaltung und die Synchronisierung mit Production.
Ephemeral Environments werden pro Pull Request, Feature oder Testlauf erzeugt. Sie bieten Isolation und vermeiden, dass mehrere Teams dieselbe Testinstanz gegenseitig verändern. Nach der Prüfung werden Anwendung, Netzwerk und Datenbank wieder entfernt. Das funktioniert besonders gut, wenn Infrastructure as Code, Container und automatisiertes Seeding bereits zuverlässig sind.
AWS beschreibt Staging weiterhin als produktionsnahe Umgebung mit manueller Genehmigung, optionalen Integrations- und Lasttests sowie IaC- und Datenbank-Versionierung. Neuere Praxisansätze ergänzen dieses Modell um Preview-Umgebungen und kurzlebige Datenbanken für Schemaänderungen. Die Wahl hängt deshalb von Risikoklasse, Release-Frequenz, Compliance und Plattformkapazität ab, nicht von einem allgemeinen Trend (AWS zur Wahl eines Staging-Ansatzes).
Ein volles persistentes Staging ist gerechtfertigt, wenn mehrere Bedingungen zusammenkommen:
Ephemeral Environments sind sinnvoll, wenn Änderungen unabhängig voneinander geprüft werden sollen, Pull Requests eigene Testdaten benötigen oder destruktive Migrationen sicher isoliert werden müssen. Sie ersetzen allerdings keine stabile Abnahmeumgebung, wenn Stakeholder einen gemeinsamen Stand prüfen oder ein vollständiger produktionsnaher Testlauf erforderlich ist.
Die pragmatische Lösung ist häufig hybrid: Ephemeral für Reviews, persistent für Produktionsabnahme. Das Team hält die dauerhafte Umgebung schlank, erzeugt temporäre Setups automatisiert und verwendet für beide Modelle dieselben IaC-Module, Container und Datenregeln. So sinkt der Pflegeaufwand, ohne die finale Freigabe zu entwerten.
Eine Staging Environment sollte als Produkt behandelt werden. Sie hat Eigentümer, Betriebsregeln, Sicherheitsanforderungen und messbare Freigabekriterien. Die folgende Checkliste lässt sich direkt in Architekturentscheidungen, Jira-Tickets oder Sprintaufgaben übersetzen.
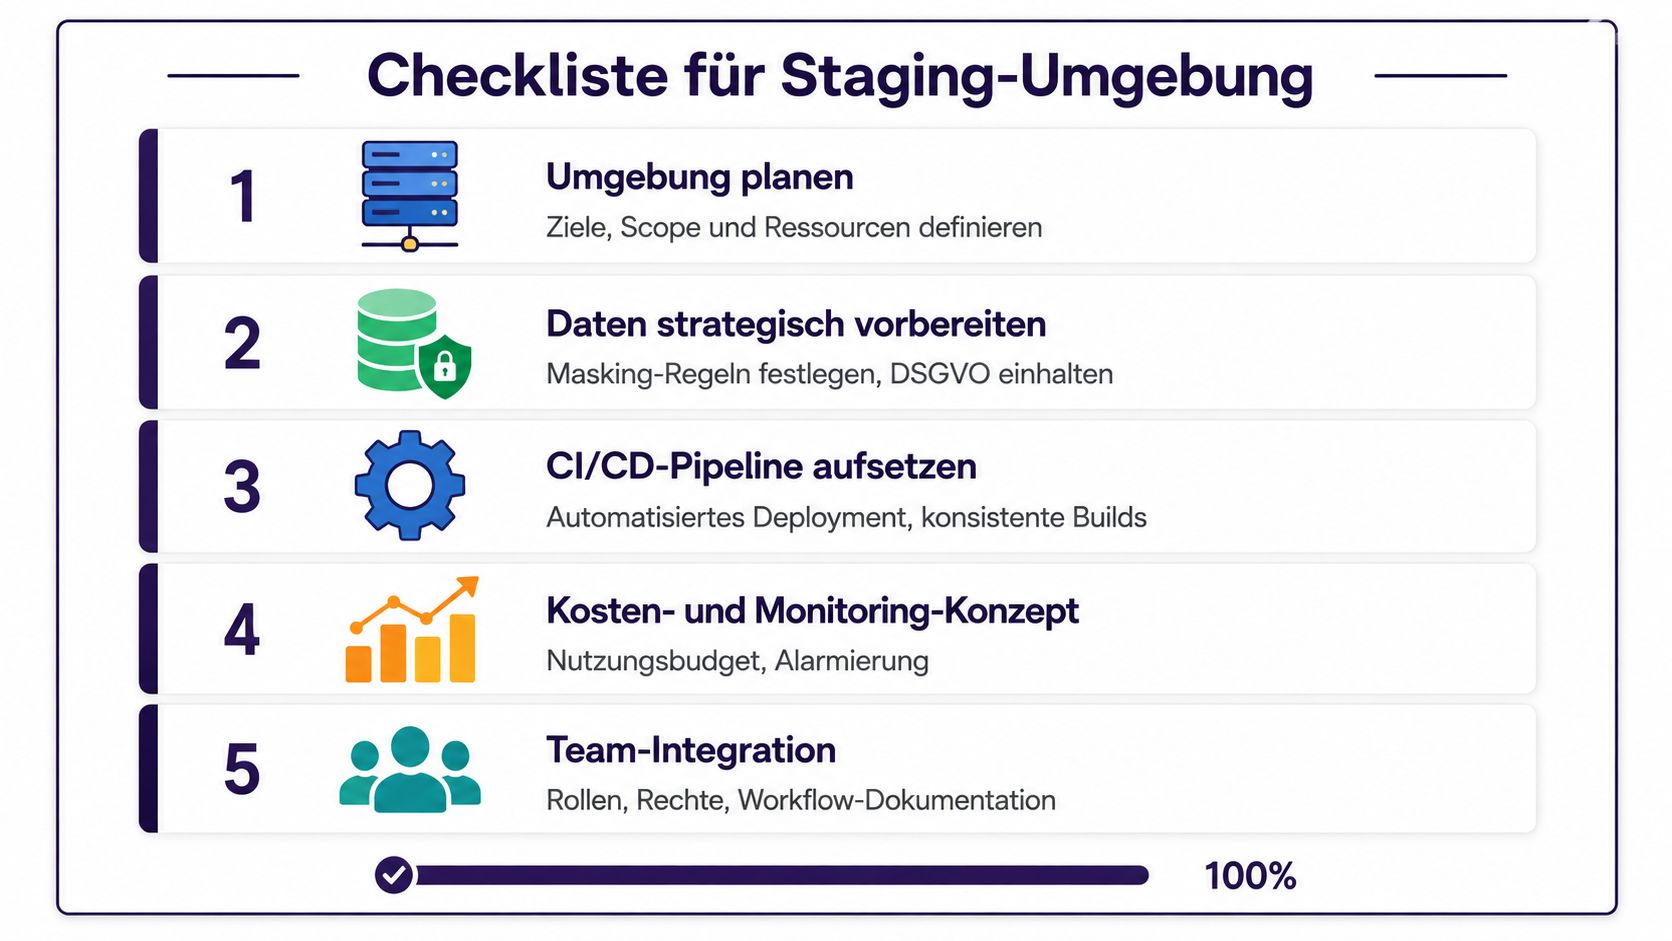
Definieren Sie zuerst, welche Freigabefragen Staging beantworten muss. Geht es um Integrationen, Migrationen, Fachbereichsabnahme, Performance oder alle Bereiche? Ordnen Sie jede Frage einer Umgebung zu und verhindern Sie, dass Staging zum Sammelbecken für ungeklärte Testfälle wird.
Legen Sie anschliessend die Parität fest. Dokumentieren Sie Runtime, Betriebssystem, Container, Datenbank, Netzwerk, externe Services, Secrets, Logging und Deploymentverfahren. Markieren Sie jede geplante Abweichung von Production mit einer Begründung.
Richten Sie getrennte Netzdomänen, Service Accounts und Datenbanken ein. Prüfen Sie explizit, dass Staging keine produktiven Schreibpfade erreicht und dass Production nicht direkt aus Testsystemen angesprochen werden kann. Rollen und Rechte sollten mindestens dieselbe Sicherheitslogik wie Production abbilden.
Definieren Sie Owner für Infrastruktur, Daten, Freigabe und Incident-Behandlung. Ohne klare Zuständigkeiten bleibt selbst eine technisch gute Umgebung im Alltag unzuverlässig.
Erstellen Sie ein Dateninventar und kennzeichnen Sie personenbezogene, vertrauliche und regulatorisch relevante Felder. Legen Sie pro Klasse fest, ob synthetische Daten, anonymisierte Ausschnitte oder temporäre Datenbanken verwendet werden.
Automatisieren Sie Maskierung und Seeding. Testen Sie nicht nur, ob die Anwendung startet, sondern auch Beziehungen, Rollen, Grenzwerte, Migrationen und typische Fehlerszenarien. Dokumentieren Sie, welche Daten nicht in Staging gelangen dürfen.
Bauen Sie das Artefakt einmal und fördern Sie es durch die Umgebungen. Verknüpfen Sie Commit, Build, Testergebnisse, Datenstand und Freigabe mit dem Change-Record. Hinterlegen Sie Approval Gates dort, wo eine echte Risikoentscheidung erforderlich ist.
Übernehmen Sie Logs, Metriken, Traces und Alerts aus Production, ohne produktive Empfänger oder sensible Inhalte zu verwenden. Prüfen Sie regelmässig, ob Fehleralarme tatsächlich auslösen und ob das Team weiss, wer reagiert.
Definieren Sie, wann persistentes Staging läuft und wann Ressourcen abgeschaltet oder verkleinert werden. Für Pull-Request-Reviews und destruktive Tests prüfen Sie Ephemeral Environments. Ein Budget-Alert sollte nicht erst erscheinen, wenn die Umgebung bereits dauerhaft gewachsen ist.
Dokumentieren Sie den Workflow für Entwickler, QA, Product Owner und Operations. Dazu gehören Erstellung, Refresh, Freigabe, Zugriff, Datenlöschung und Eskalation. Für weiterführende Perspektiven zur technischen und organisatorischen Entwicklung eines Unternehmens bietet Insights für Ihr Unternehmen von Küstermann Media GmbH ergänzende Inhalte.
"Abschlussprüfung: Ein Release ist erst bereit, wenn das Team weiss, welches Artefakt getestet wurde, mit welchen Daten es lief, welche Risiken offen sind und wer die Promotion verantwortet."
PandaNerds unterstützt Unternehmen beim Aufbau und bei der Weiterentwicklung von Softwareteams, unter anderem mit erfahrenen Entwicklern für CI/CD, Cloud-Infrastruktur und produktionsnahe Testprozesse. Besuchen Sie PandaNerds, wenn Sie Ihre Staging-Architektur pragmatisch umsetzen oder dafür kurzfristig passende Senior-Entwickler in Ihr Team integrieren möchten.