02.07.2025
Asana vs. Trello: Welches Projektmanagement-Tool ist besser?
Asana vs. Trello: Welches Projektmanagement-Tool ist besser? Wir vergleichen beide Tools im Projektmanagement. Welches Tool passt besser zu Ihren Zielen?
get started


Montagmorgen, der Produktivdienst ist nicht erreichbar. Das Team weiß, dass Sicherungen existieren, aber niemand kann sofort sagen, welche davon sauber ist, wer die Wiederherstellung freigibt oder in welcher Reihenfolge Datenbank, Identitätsdienst und Anwendung starten müssen. Genau in dieser Lücke zeigt sich, ob ein Unternehmen einen belastbaren Disaster-Recovery-Plan hat oder nur Backups.
Für CTOs, Gründer und IT-Leiter in deutschen KMU und Scale-ups ist die Entscheidung nicht, ob ein Ausfall irgendwann möglich ist. Entscheidend ist, ob das Team unter Druck verlässlich weiterarbeiten und Systeme geordnet wiederherstellen kann. Dafür braucht es klare Prioritäten, praktikable Runbooks und geübte Abläufe, nicht mehr Seiten Dokumentation.
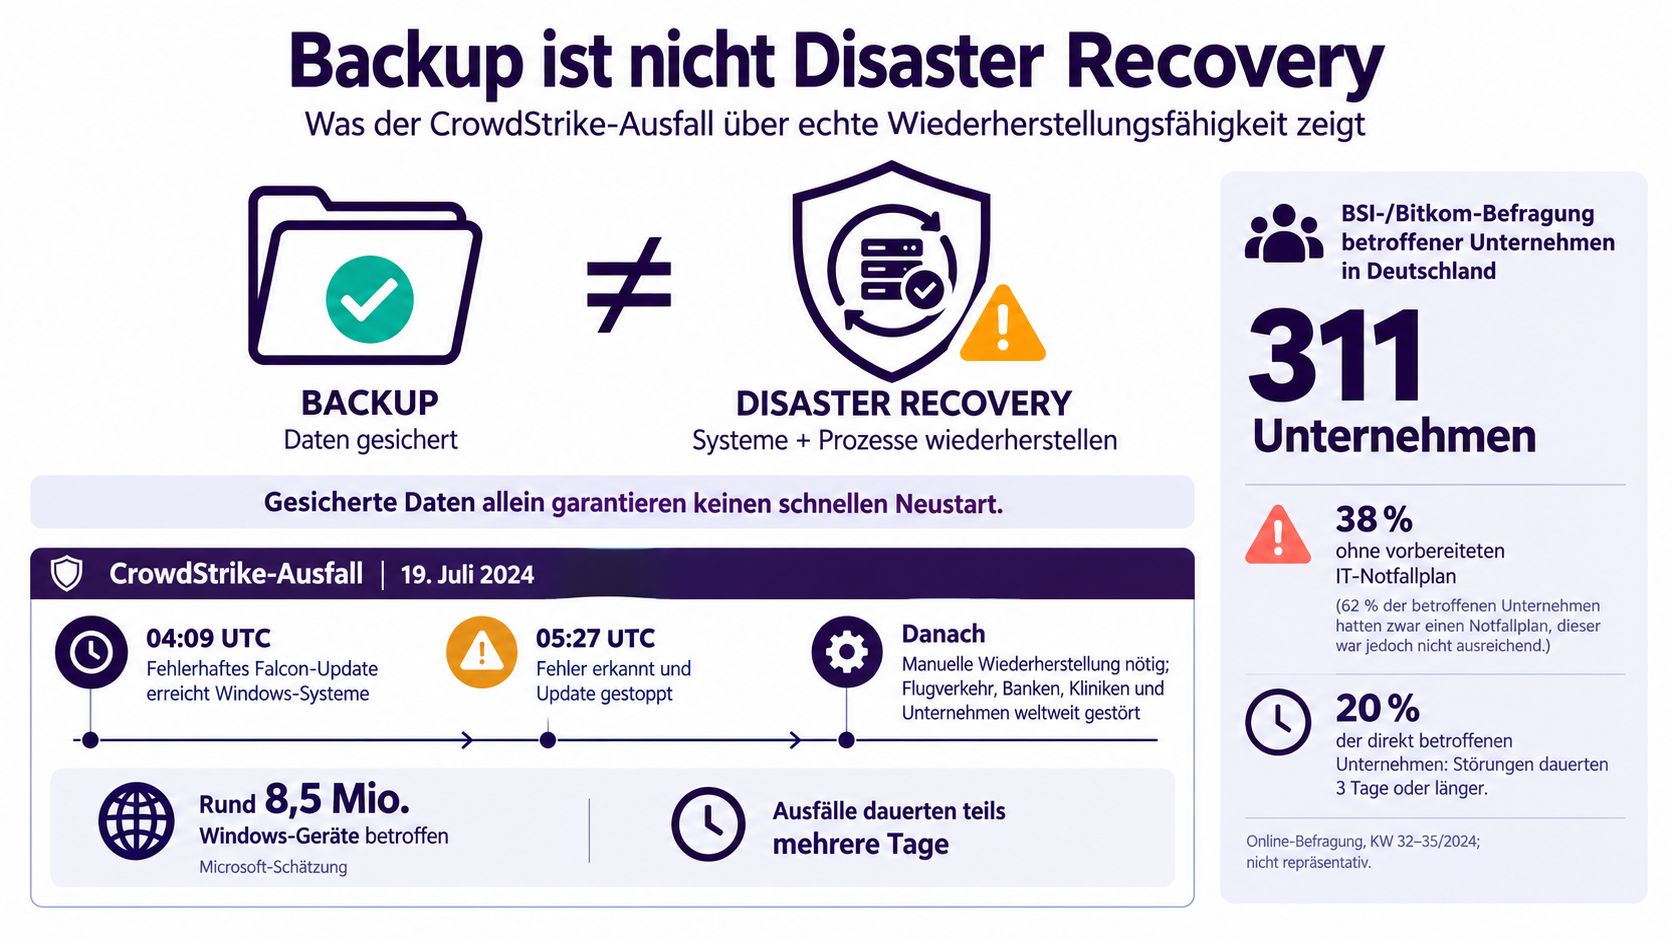
Ein Backup ist eine Kopie. Disaster Recovery ist der betriebliche Ablauf, mit dem ein Unternehmen nach einem Ausfall wieder arbeitsfähig wird. Dazu gehören die Frage, welche Systeme zuerst zurückkommen, wer Entscheidungen trifft, wie das Team kommuniziert und wie die Wiederherstellung getestet wird. Wer diese Punkte nicht beantwortet, hat keinen vollständigen Recovery-Plan.
Der CrowdStrike-Vorfall im Juli 2024 macht den Unterschied deutlich. In einer BSI-Befragung von 311 betroffenen Unternehmen meldeten 62 Prozent direkte Auswirkungen, etwa ausgefallene PCs oder Server, und 48 Prozent indirekte Auswirkungen über Zulieferer, Kunden oder Geschäftspartner. 62 Prozent besaßen bereits einen Notfallplan. Trotzdem musste knapp die Hälfte den Betrieb vorübergehend einstellen, durchschnittlich für zehn Stunden. Bei 20 Prozent der direkt betroffenen Unternehmen dauerten die Folgen mindestens drei Tage.
Das Problem ist selten, dass niemand an Backups gedacht hat. Häufig fehlen getestete Wiederanlaufwege, eindeutige Zuständigkeiten oder ein Kommunikationsplan. Ein Backup kann vorhanden sein und dennoch im Ernstfall unbrauchbar bleiben, etwa wenn die Zugangsdaten fehlen, die Sicherung mit kompromittierten Konten erreichbar ist oder das Team nicht weiß, welche Systeme zuerst wiederhergestellt werden müssen.
Ein belastbarer Plan deckt fünf Bereiche ab:
Praktische Regel: Eine Sicherung zählt erst dann als Recovery-Fähigkeit, wenn das Team sie unter realistischen Bedingungen wiederhergestellt hat.
Disaster Recovery beginnt nicht mit der Serverliste. Es beginnt mit der Frage, welche Geschäftsprozesse ausfallen dürfen, wie lange sie ausfallen dürfen und welche technischen oder externen Abhängigkeiten ihren Betrieb ermöglichen. Das BSI beschreibt Notfallmanagement als systematischen Prozess, der mit einer Business-Impact-Analyse (BIA) kritische Prozesse und Abhängigkeiten erfasst, bevor maximale Ausfallzeiten und tolerierbarer Datenverlust festgelegt werden. Den Grundgedanken des strukturierten Risikovergleichs vertieft auch dieser Beitrag zur Risikobewertungsmatrix.
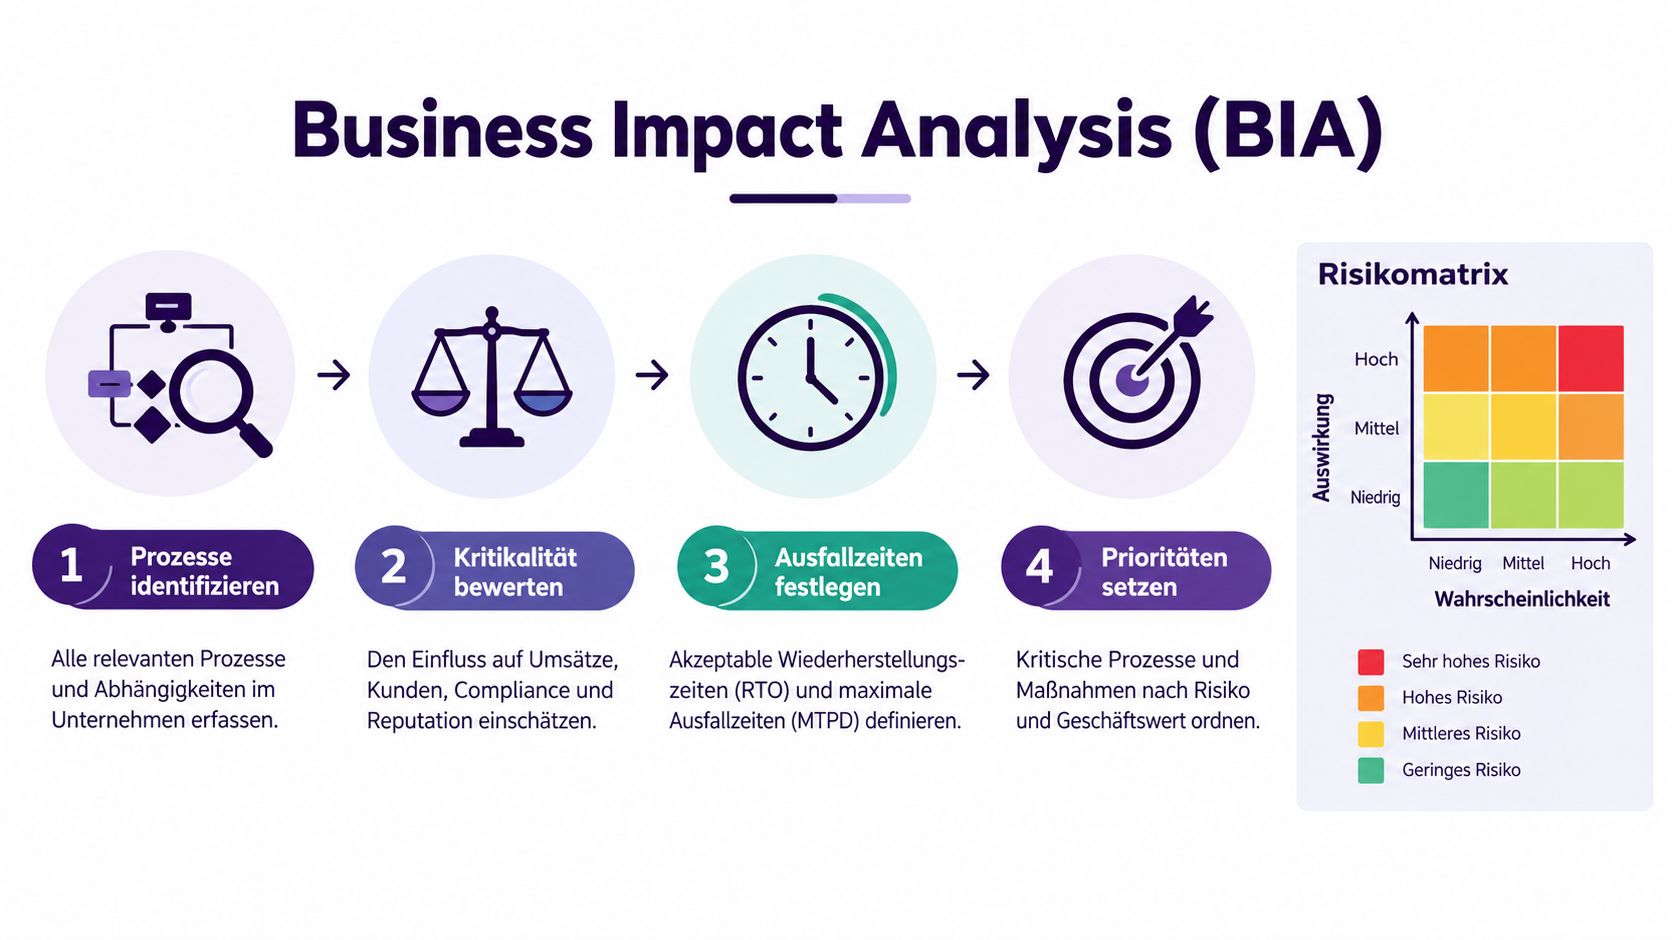
Beginnen Sie mit den Geschäftsleistungen, nicht mit den Geräten. Ein Softwareunternehmen könnte etwa Kundenanmeldung, Zahlungsabwicklung, Produktbetrieb und Support als Prozesse erfassen. Fragen Sie die jeweiligen Fachverantwortlichen, was bei einem Ausfall tatsächlich nicht mehr möglich ist und welche manuellen Ersatzverfahren es gibt. Eine pauschale Einstufung wie „alle Produktivsysteme kritisch“ hilft bei der Wiederanlaufreihenfolge nicht.
Ordnen Sie anschließend jedem Prozess seine Abhängigkeiten zu. Für eine Webanwendung können dazu Authentifizierung, Quellcodeverwaltung, CI/CD, Produktivdatenbank und Kundenkommunikation gehören. Ergänzen Sie weniger sichtbare Voraussetzungen wie DNS, Zahlungsdienstleister, Cloud-Konten, Secrets, Zertifikate oder externe Supportteams. Ein System ist nicht wiederhergestellt, nur weil der Server läuft. Es muss seinen Geschäftsprozess tatsächlich wieder ermöglichen.
Bewerten Sie mögliche Ausfälle anhand ihrer Folgen für Kunden, Umsatz, Betrieb und regulatorische Pflichten. Dokumentieren Sie, wer die Bewertung bestätigt hat und welche Annahmen ihr zugrunde liegen. Fehlen Gespräche mit Fachabteilungen, übersieht das IT-Team leicht, dass ein scheinbar internes Werkzeug inzwischen für einen kundenkritischen Ablauf gebraucht wird.
Am Ende der BIA steht eine verständliche Rangfolge. Für jedes priorisierte Geschäftsergebnis sollte klar sein, welche Systeme dafür benötigt werden, welche Abhängigkeiten zuerst verfügbar sein müssen und welche Alternative vorübergehend reicht. So entsteht die Basis für konkrete Wiederherstellungsziele, statt einer Liste von Servern ohne geschäftlichen Kontext.
Aus der BIA folgen zwei Steuerungsgrößen. Das Recovery Time Objective (RTO) beschreibt, wie lange ein System höchstens ausfallen darf, bevor die Folgen für den Betrieb nicht mehr akzeptabel sind. Das Recovery Point Objective (RPO) legt fest, wie alt die wiederhergestellten Daten maximal sein dürfen. Beide Werte gelten pro Prozess oder System, nicht pauschal für das ganze Unternehmen.
Das BSI ordnet diese Ziele in den systematischen Aufbau des Notfallmanagements ein: Erst werden kritische Geschäftsprozesse und Abhängigkeiten erfasst, anschließend maximale Ausfallzeiten und Datenverluste festgelegt. Das RTO muss innerhalb der tolerierbaren Ausfallzeit liegen. Das RPO wiederum muss zur tatsächlichen Sicherungsmethode passen.
| Systemklasse | Beispiel | RTO | RPO |
|---|---|---|---|
| Kundenkritisch | Authentifizierungsdienst | 1 Stunde | 5 Minuten |
| Geschäftskritisch | Produktivdatenbank | Aus der BIA festlegen | Aus dem tolerierbaren Datenverlust ableiten |
| Unterstützend | Internes Wiki | 24 Stunden | 24 Stunden |
Die Tabelle zeigt mögliche Anforderungen, keine allgemeingültigen Vorgaben. Wenn Authentifizierung für Kunden und Mitarbeitende unverzichtbar ist, kann ein Unternehmen eine kurze Wiederanlaufzeit festlegen. Ein internes Wiki kann dagegen länger nicht verfügbar sein, sofern wichtige Betriebsanweisungen an anderer Stelle erreichbar sind.
Ein RPO von 15 Minuten lässt sich nicht mit einem täglichen Backup erreichen. Dafür braucht es häufigere Sicherungen oder Replikation. Diese Wahl wirkt sich auf Infrastruktur, Kosten, Überwachung und Wiederherstellungsabläufe aus. Replikation allein ist dabei kein Ersatz für Backup: Sie kann auch versehentliche Löschungen oder beschädigte Daten weitergeben.
Setzen Sie Ziele nicht danach, was auf einer Folie gut aussieht. In einer Cohesity-Erhebung berichteten 65 Prozent der deutschen Unternehmen nach schwerwiegenden Cyberangriffen von einer spürbaren Verzögerung bei der Rückkehr zum normalen Geschäftsbetrieb. Gleichzeitig erwarteten 29 Prozent der deutschen CEOs eine vollständige Wiederherstellung innerhalb eines Tages. Die Lücke ist ein guter Grund, jedes Ziel durch einen Test zu belegen. Wenn das Team das RTO nicht unter den vorgesehenen Bedingungen erreichen kann, muss es entweder die technische Strategie ändern oder das Geschäftsziel neu verhandeln.
Die passende Sicherungsstrategie hängt davon ab, welche Wiederherstellungszeit das Geschäft verlangt und welche Betriebsform das Team zuverlässig betreuen kann. Cloud-Backup kann die Bereitstellung und Skalierung vereinfachen, bindet die Wiederherstellung aber an Cloud-Konten, Berechtigungen und die Verbindung zum Anbieter. On-Premises-Backups geben dem Unternehmen unmittelbare Kontrolle über Speicher und Zugriff, verlangen dafür eigene Infrastruktur, Wartung und klare Zuständigkeiten.
| Kriterium | Cloud | On-Premises |
|---|---|---|
| Betrieb | Anbieter stellt Speicher und Dienste bereit, das Unternehmen verwaltet Konfiguration und Zugriffe | Das Unternehmen verantwortet Hardware, Medien, Software und Wartung |
| Skalierung | Kapazität lässt sich über den Dienst anpassen | Kapazität hängt von installierter Infrastruktur ab |
| Kontrolle | Zugriff und Wiederherstellung sind an Konten und Dienstleister gebunden | Direkte Kontrolle über Speicher und Betriebsumgebung |
| Wiederanlauf | Hängt von Datenvolumen, Verbindungen und Wiederherstellungsweg ab | Hängt von Standort, verfügbarem Ersatzsystem und Medienzugriff ab |
| Kostenmodell | Laufende Nutzung und Speicherverbrauch | Anschaffung, Betrieb, Austausch und Personalaufwand |
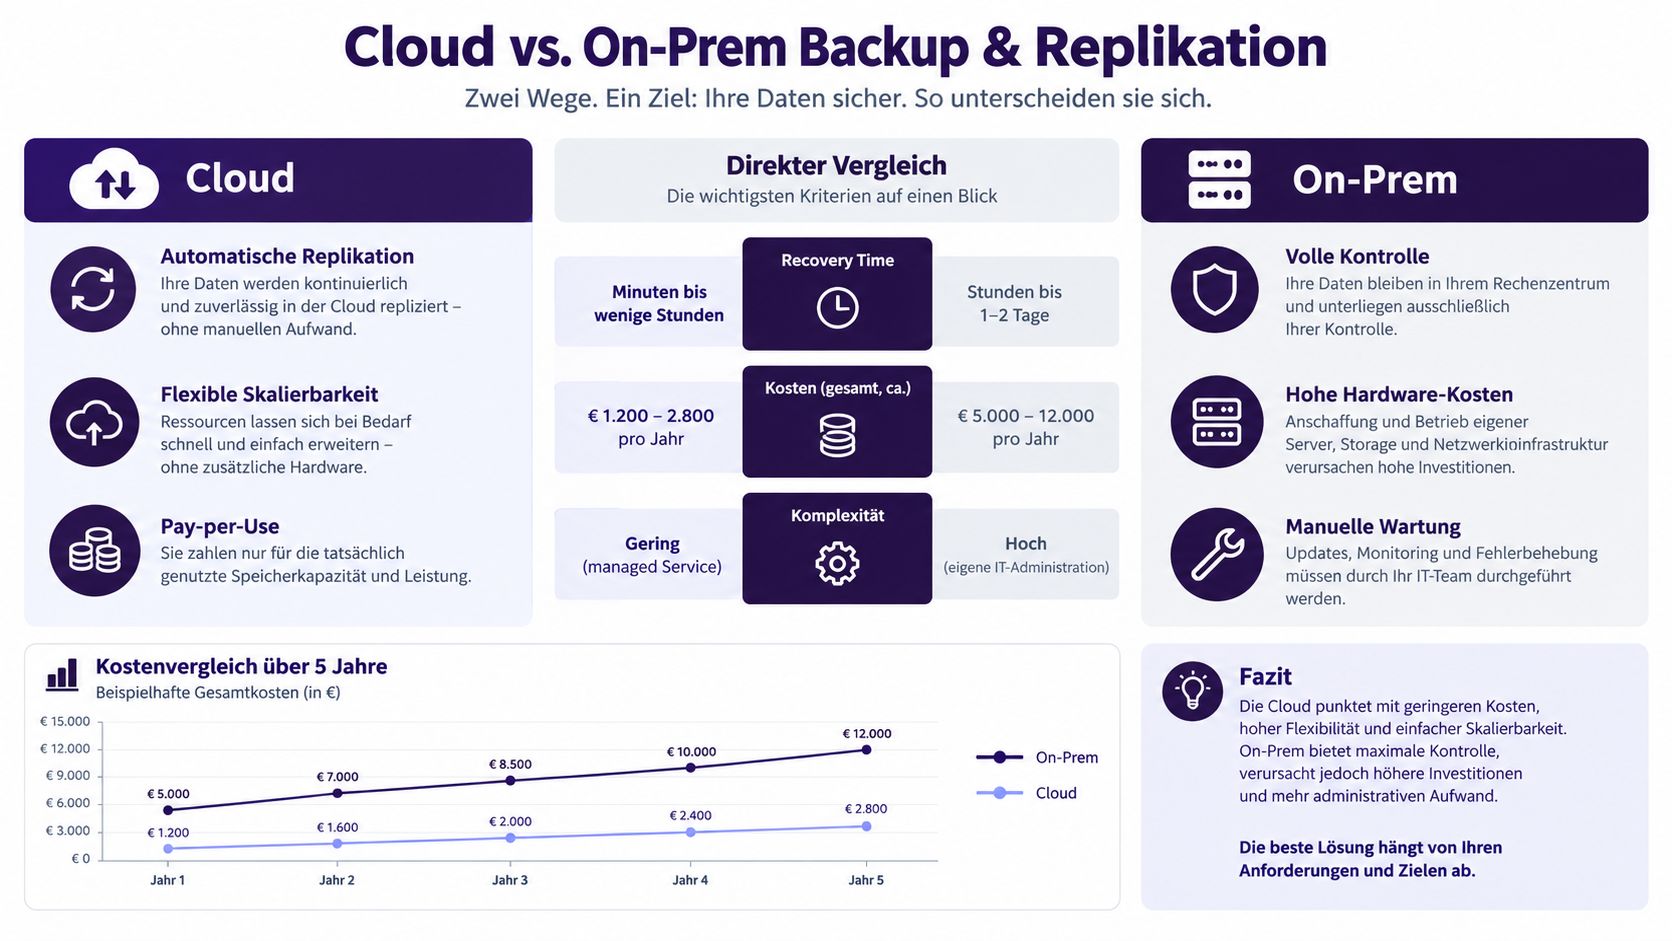
Die 3-2-1-Regel kann ein nützlicher Ausgangspunkt für die Gestaltung von Sicherungen sein, beantwortet aber nicht, ob eine Kopie nach einem Angriff erreichbar und wiederherstellbar ist. Das BSI empfiehlt, Backups nach dem Sicherungsvorgang von den übrigen Systemen und Netzwerken zu trennen, damit Angreifer sie nicht ebenfalls verschlüsseln oder löschen können. Es betont außerdem, dass Wiederanlauf und Rücksicherung vorbereitet werden müssen. Die BSI-Empfehlungen zu Ransomware-Schutzmaßnahmen sind daher nicht als Speicherfrage, sondern als Betriebsanforderung zu lesen.
Für viele KMU ist ein hybrides Modell praktikabler als eine Alles-oder-nichts-Entscheidung. Eine Replikation in eine getrennte Cloud-Region kann den Wiederanlauf unterstützen, während eine Offline-Kopie einen unabhängigen Rückweg bietet. Entscheidend ist, dass Backup-Konten, Schlüssel und Zugriffspfade nicht vollständig von der betroffenen Produktionsumgebung abhängen. Prüfen Sie außerdem Datenhoheit, vertragliche Wiederherstellungsleistungen und den Weg zurück zu einer anderen Betriebsumgebung.
Replikation hält Systeme aktuell. Sie bewahrt nicht automatisch einen sauberen Wiederherstellungspunkt.
Im Notfall zählt nicht die Absichtserklärung, sondern eine nachvollziehbare Abfolge von Handlungen. Ein Runbook beschreibt die Wiederherstellung eines konkreten Systems. Ein Playbook legt fest, wie Teams auf eine übergreifende Lage reagieren, etwa einen kompromittierten Cloud-Zugang oder einen Ausfall beim Hosting-Anbieter.
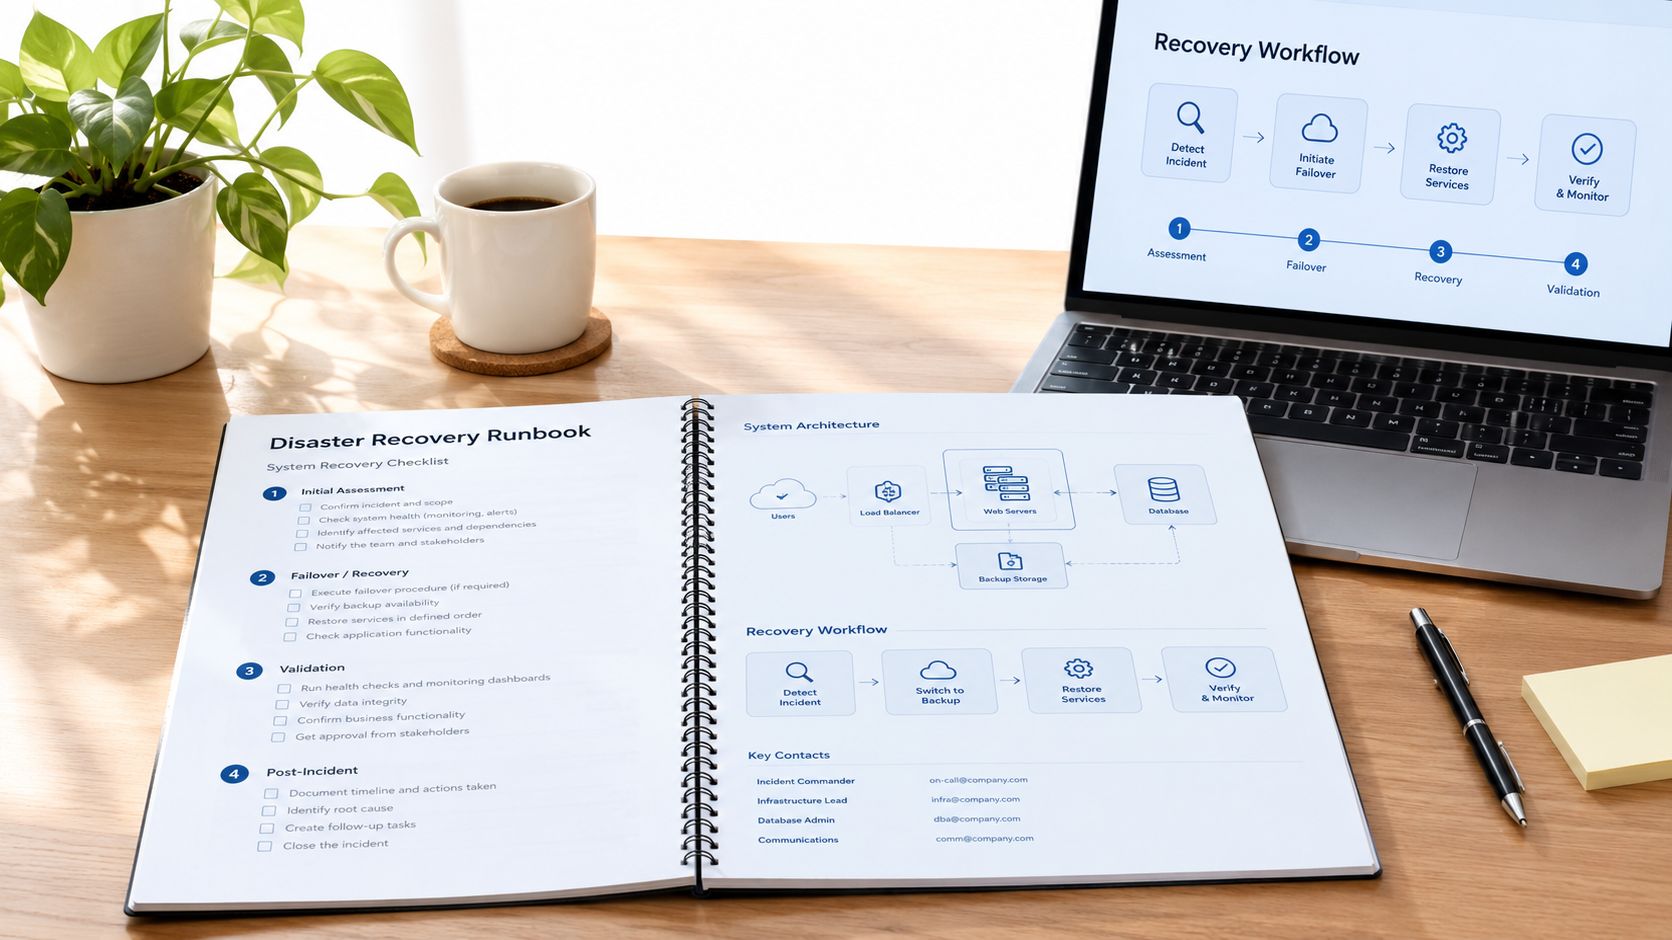
Ein brauchbares Runbook nennt zuerst Auslöser und Verantwortliche: Wer darf die Wiederherstellung starten, wer entscheidet über den Wechsel auf eine Ersatzumgebung und wer informiert Kunden oder Geschäftsleitung? Danach folgen Voraussetzungen, Eskalationsweg und Abhängigkeiten. Für eine Webanwendung könnte die Wiederanlaufreihenfolge lauten: Identitätsdienst und privilegierte Zugänge prüfen, Datenbank aus einer freigegebenen Sicherung wiederherstellen, Anwendung starten, Cache kontrolliert aufbauen und anschließend Kundenfunktionen validieren.
Dokumentieren Sie konkrete Prüfungen und Aktionen, nicht nur Ziele. Das Runbook sollte festhalten, wie das Team erkennt, dass die Datenbank konsistent ist, wie es die Anwendung gegen die wiederhergestellte Datenquelle testet und unter welchen Bedingungen es den Dienst wieder freigibt. Zugangsdaten gehören in einen verwalteten Passwort-Tresor oder ein vergleichbares Verfahren, nicht in frei zugängliche Dokumente.
Ein Runbook, das nur eine Person bedienen kann, ist ein Personalrisiko. Definieren Sie für jede zentrale Rolle eine Vertretung, halten Sie Notfallkontakte aktuell und prüfen Sie, ob das Team auf Dokumentation und Werkzeuge zugreifen kann, wenn der primäre Identitätsdienst ausfällt. Externe Entwickler und Betriebspartner müssen wissen, wie sie alarmiert werden und welche Aufgaben sie im Ereignis übernehmen.
Die Dokumentation sollte dort liegen, wo das Team sie im Ausfall noch erreicht. Eine gepflegte Dokumentation in Confluence kann helfen, wenn Zugriffsrechte, Offline-Verfügbarkeit und Änderungsprozesse bewusst geregelt sind. Verlassen Sie sich nicht darauf, dass ein einziges internes Wiki stets erreichbar ist. Entscheidend ist, dass mindestens eine Person außerhalb der ausgefallenen Umgebung an die nötigen Anweisungen kommt.
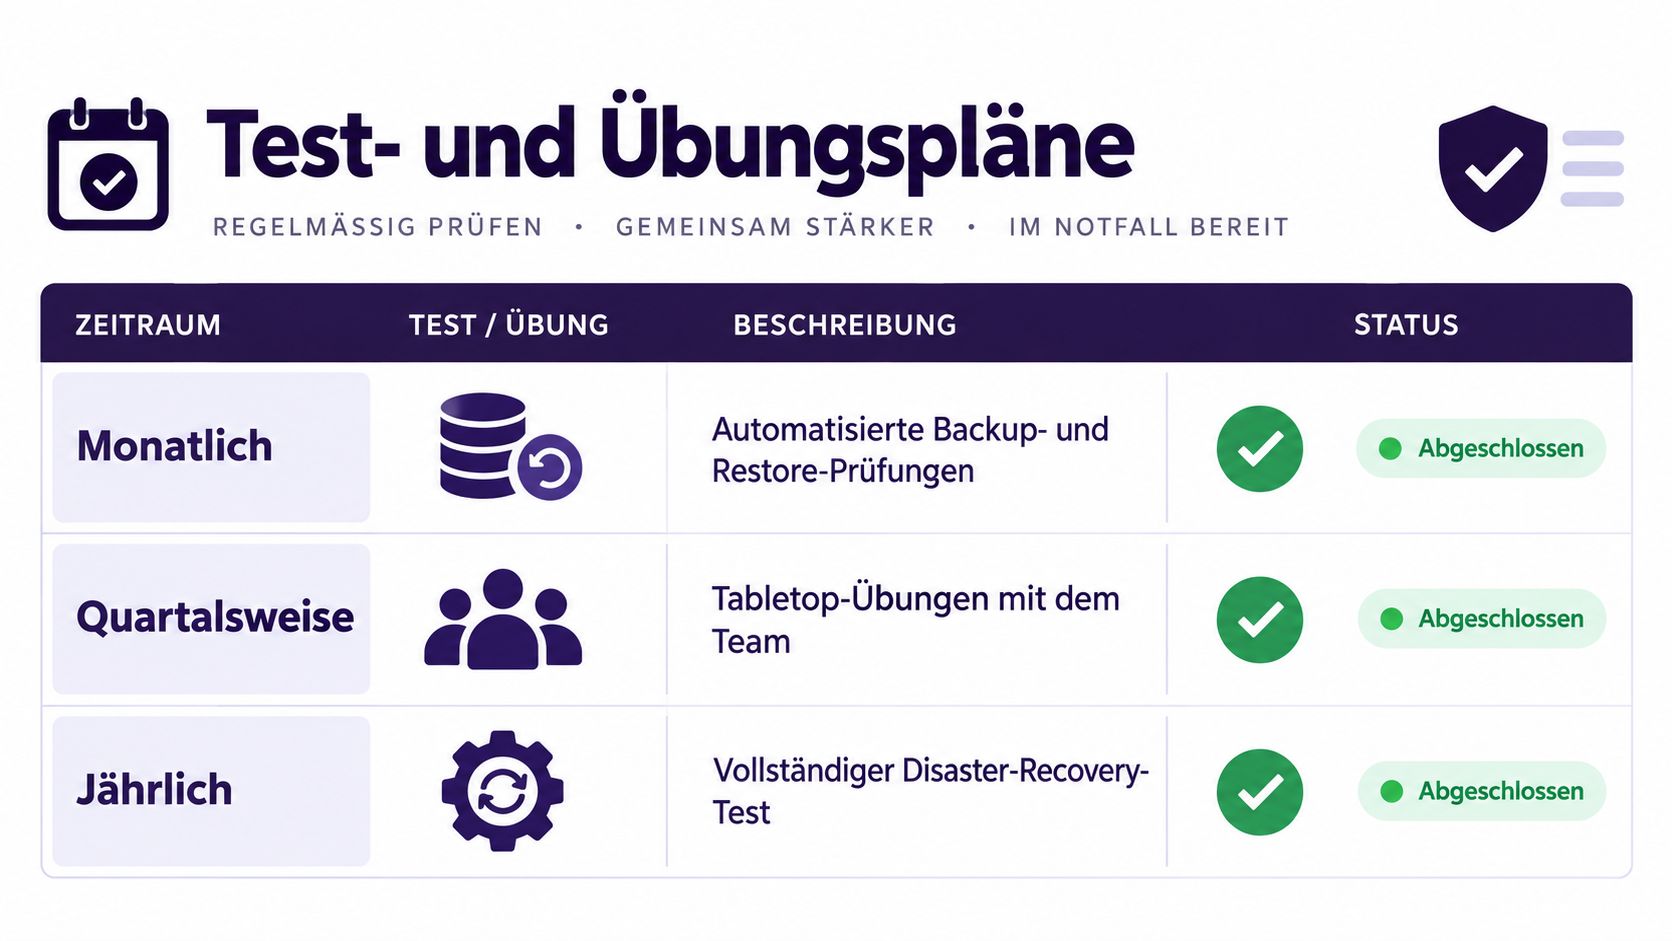
Ein Plan, der nie ausgeführt wurde, belegt keine Wiederherstellungsfähigkeit. Legen Sie einen wiederkehrenden Prüfzyklus fest, der technische Wiederherstellung und Zusammenarbeit des Teams umfasst. Die folgende Matrix ist ein praktikabler Mindeststandard für viele Entwicklungsorganisationen.
| Rhythmus | Prüfung | Was nachzuweisen ist |
|---|---|---|
| Monatlich | Automatisierte Backup- und Restore-Prüfungen | Sicherung lesbar, Wiederherstellung abgeschlossen, Ergebnis protokolliert |
| Quartalsweise | Wiederherstellung einzelner Systeme und Teamübung | Rollen, Zugänge und Abhängigkeiten funktionieren im festgelegten Szenario |
| Jährlich | End-to-End-Test in einer isolierten Ersatzumgebung | Kritische Dienste und Geschäftsabläufe lassen sich gemeinsam wiederherstellen |
Erfassen Sie bei jedem Durchlauf die Restore-Dauer, das Alter der wiederhergestellten Daten, Fehler, manuelle Eingriffe und die Abweichung vom vereinbarten RTO und RPO. Notieren Sie außerdem, welche Zugangsdaten fehlten, welche Abhängigkeit das Team übersehen hatte und ob die Wiederherstellung tatsächlich einen Geschäftsprozess ermöglicht hat. Ein gestarteter Server ist kein erfolgreicher Test, wenn Mitarbeitende sich nicht anmelden oder Kunden nicht auf ihre Daten zugreifen können.
Die Flutkatastrophe von 2021 zeigt, warum Übungen nicht auf IT-Systeme beschränkt bleiben dürfen. In einer Befragung von 431 geschädigten Unternehmen in Nordrhein-Westfalen und Rheinland-Pfalz hatten 77 Prozent eine Betriebsunterbrechung erlitten. Nur 21,3 Prozent konnten direkte Schäden innerhalb von sechs Monaten vollständig beheben, und bei 51,3 Prozent waren die direkten Schäden zum Befragungszeitpunkt noch nicht vollständig behoben. Ein Recovery-Szenario sollte deshalb auch alternative Arbeitsorte, Stromversorgung, Telekommunikation, Lieferanten, Personalverfügbarkeit und Kundenkommunikation einbeziehen.
Jeder fehlgeschlagene Test braucht eine konkrete Maßnahme mit verantwortlicher Person und Termin. „Dokumentation verbessern“ ist zu vage. Schreiben Sie stattdessen fest, welches System oder welcher Zugang fehlt, wer die Änderung umsetzt und wie der nächste Test den Erfolg nachweist. Ungetestete Backups, fehlende Offline-Kopien und ungeklärte Zuständigkeiten sind keine nebensächlichen Dokumentationsmängel. Sie sind offene Betriebsrisiken.
Ein Disaster-Recovery-Plan braucht eine klare Trennung zwischen Verantwortung und Ausführung. Das Unternehmen bleibt dafür verantwortlich, dass seine kritischen Prozesse wiederherstellbar sind, auch wenn Cloud-Betrieb, Entwicklung oder Support an Dienstleister ausgelagert wurden. Ein Vertrag ersetzt weder einen Wiederherstellungsweg noch den Zugriff auf die dafür nötige Dokumentation.
Für Einrichtungen, die unter die deutschen NIS-2-Pflichten fallen, muss der Ablauf auch Meldungen erheblicher Sicherheitsvorfälle berücksichtigen. Das BSI beschreibt eine frühe Erstmeldung innerhalb von 24 Stunden nach Kenntniserlangung, eine aktualisierte Meldung innerhalb von 72 Stunden und eine Abschluss- oder Folgemeldung innerhalb von 30 Tagen. Die konkreten Pflichten und Anwendungsbereiche sollten Unternehmen anhand der BSI-Informationen zu NIS-2-Meldepflichten prüfen und in ihrer Compliance-Planung abbilden. Wer erst während der Wiederherstellung nach Zuständigkeiten, Bereitschaftskontakten und Mindestinformationen sucht, verliert wertvolle Zeit.
Für KRITIS-Betreiber und weitere regulierte Bereiche können zusätzliche Meldewege gelten. Das BSI verweist für IT-Störungen oberhalb der Schwellenwerte der BSI-Kritisverordnung auf § 32 BSIG. Betreiber von Telekommunikationsnetzen und -diensten müssen Sicherheitsverletzungen nach § 168 TKG dem BSI und der Bundesnetzagentur melden. Bestimmte Pflichten gelten außerdem für Vertrauensdiensteanbieter. Führen Sie deshalb je Geschäftsbereich eine passende Behörden- und Kommunikationsmatrix. Eine allgemeine Kontaktliste für alle Vorfälle genügt nicht.
Für jeden wichtigen Dienstleister sollte der Plan mindestens diese Fragen beantworten:
Outsourcing kann die Arbeit verteilen, aber nicht die Verantwortung. Machen Sie Abhängigkeiten messbar und planen Sie mindestens einen unabhängigen Wiederherstellungsweg. Für Entwicklungsorganisationen kann das bedeuten, Repository-Mirrors, Secrets, Build-Artefakte und Infrastruktur-Code unabhängig vom primären Cloud-Konto wiederherstellbar zu halten.
Gehen Sie in einer Reihenfolge vor, die zuerst Klarheit schafft und dann technische Entscheidungen absichert:
Prüfen Sie am Ende, ob Wiederherstellungen getestet, Zugänge dokumentiert, Verantwortliche benannt, Meldewege passend zum regulatorischen Status festgelegt und Exit-Szenarien für wichtige externe Partner beschrieben sind. Häufige Fehler sind pauschale Prioritäten, unerprobte Backups, fehlende Offline-Kopien, Single Points of Failure bei Schlüsselpersonen und die Annahme, Cloud-Verfügbarkeit ersetze einen eigenen Recovery-Prozess.
Mit kleinem Team starten Sie pragmatisch: Wählen Sie zuerst einen geschäftskritischen Prozess, schreiben Sie dafür ein ausführbares Runbook und testen Sie es mit den vorhandenen Ressourcen. Ziehen Sie externes Know-how hinzu, wenn intern Erfahrung für Wiederherstellungsautomatisierung, Testskripte oder eine belastbare technische Architektur fehlt. Senior-Entwickler können solche Aufgaben in bestehende Teams integrieren, ohne dass das Unternehmen die Verantwortung für seine Wiederherstellungsfähigkeit abgibt.
PandaNerds unterstützt Unternehmen dabei, erfahrene Entwickler in bestehende Teams zu integrieren, auch für Aufgaben wie Runbook-Automatisierung und Recovery-Testskripte. Wenn Sie Ihren Disaster-Recovery-Plan operativ belastbar machen wollen, sprechen Sie mit PandaNerds über passende technische Unterstützung.