02.07.2025
Asana vs. Trello: Welches Projektmanagement-Tool ist besser?
Asana vs. Trello: Welches Projektmanagement-Tool ist besser? Wir vergleichen beide Tools im Projektmanagement. Welches Tool passt besser zu Ihren Zielen?
get started


Die populärste Empfehlung zur Risikomatrix lautet immer noch, man solle sie einmal aufsetzen, farbig markieren und dann im Audit-Ordner ablegen. Für Software-Teams ist das zu wenig. In echten Projekten ändern sich Abhängigkeiten, Lieferwege und Verantwortlichkeiten ständig, deshalb braucht eine Risk Assessment Matrix kein statisches Formular, sondern ein lebendes Entscheidungsinstrument.
Die meisten Matrizen verstauben nicht, weil Teams das Thema ignorieren, sondern weil die Matrix zu weit von der Projektrealität entfernt ist. Ein Eintrag zu „mittlerem Risiko“ hilft niemandem, wenn am nächsten Tag ein externer Dienstleister ausfällt, ein MVP verschoben wird oder ein Schlüsselentwickler weg ist. Für CTOs und Engineering Leads ist die Matrix dann nur dann nützlich, wenn sie technische, terminliche, sicherheitsbezogene und personelle Risiken gemeinsam sichtbar macht und daraus eine klare Eskalation ableitet.
In Deutschland ist Risikomanagement nicht als Modewort entstanden, sondern historisch und normativ verankert. Das KonTraG trat am 1. Mai 1998 in Kraft und verpflichtete Unternehmen, bestandsgefährdende Entwicklungen früh zu erkennen und Überwachungsmechanismen einzurichten. Später folgten das BilReG von 2004, das BilMoG von 2009 und international ISO 31000 im Jahr 2009, dessen in Deutschland veröffentlichte Fassung DIN ISO 31000 am 1. Oktober 2018 erschien. (DIN Media zum Risikomanagement)
Das ist wichtig, weil die Norm gerade keine einzelne Matrixform vorschreibt. Sie etabliert einen Prozess zur Identifikation, Analyse, Bewertung und Behandlung von Risiken. Eine Matrix ist darin nur das Übersetzungswerkzeug, das Wahrscheinlichkeit und Schadensausmaß in eine priorisierende Stufe überführt. Genau deshalb funktioniert sie in Softwareprojekten dann gut, wenn sie als Teil eines dokumentierten Systems genutzt wird, nicht als isoliertes Excel-Blatt.
Praktische Regel: Eine gute Matrix beantwortet nicht nur „Wie groß ist das Risiko?“, sondern auch „Wer entscheidet jetzt was?“.
Eine Matrix liefert keine objektive Wahrheit, wenn die Skalen schwammig bleiben. Wörter wie „mittel“ oder „hoch“ sind für Engineering-Teams zu ungenau, weil verschiedene Personen dieselbe Situation unterschiedlich lesen. Wer Cloud-Ausfälle, MVP-Verzögerungen oder Datenschutzverletzungen bewerten will, braucht feste Anker, die im Team gleich verstanden werden.
Am besten bewährt hat sich eine 4- oder 5-stufige Skala mit klaren verbalen Definitionen. Nicht die Zahl selbst macht die Bewertung brauchbar, sondern die Vereinbarung dahinter. Wenn „wahrscheinlich“ nur gefühlt wahrscheinlich ist, entstehen Pseudo-Genauigkeit und Streit im Review.
Ein brauchbarer Startpunkt sieht so aus:
| Stufe | Eintrittswahrscheinlichkeit (Anker) | Schadensausmaß (Anker) |
|---|---|---|
| Niedrig | tritt nur unter besonderen Umständen auf | begrenzte Verzögerung oder lokaler Zusatzaufwand |
| Eher niedrig | möglich, aber nicht der Normalfall | spürbare Mehrarbeit, aber keine Eskalation |
| Mittel | realistisches Szenario im Projektverlauf | Termin- oder Qualitätsrisiko mit sichtbarer Wirkung |
| Hoch | tritt unter ähnlichen Bedingungen regelmäßig auf | erhebliche Verzögerung, Sicherheits- oder Betriebsrisiko |
| Sehr hoch | ist in der aktuellen Konstellation fast zu erwarten | kritischer Schaden, harte Eskalation oder Projektstopp |
Diese Skala wird erst stark, wenn sie mit konkreten Annahmen verbunden wird. Bei Cloud-Diensten bedeutet das zum Beispiel, dass Verfügbarkeit, Support-Reaktionszeiten oder Abhängigkeiten vom Anbieter dokumentiert sind. Bei Open-Source-Komponenten geht es um Patch-Verhalten, Betreuungsgrad und den Aufwand, eine Bibliothek notfalls zu ersetzen.
Wichtiger Punkt: Die Bewertung muss dieselbe Sprache im Management und im Engineering sprechen. Wenn Product sagt „verzögert den Launch“, während Engineering von „technischer Schuld“ spricht, fehlt die gemeinsame Klammer.
Die zweite Falle ist die Scheingenauigkeit einer komplexen Matrix. Für viele Teams ist eine einfache 3x3-Struktur belastbarer als eine überladene 5x5-Tabelle, solange die Definitionen sauber sind. Nicht die Größe der Matrix entscheidet, sondern die Qualität der Anker und die Disziplin bei der Anwendung.
Eine gute Matrix beginnt nicht mit dem Eintragen von Risiken, sondern mit einem strukturierten Prozess. Der klassische Acht-Schritte-Ansatz aus der Gefährdungsbeurteilung lässt sich direkt auf Software-Teams übertragen, wenn man ihn in die Sprache von Tickets, Deployments und Architekturentscheidungen übersetzt. Das macht die Methode anschlussfähig für Jira, Notion oder jedes andere Arbeitsboard.
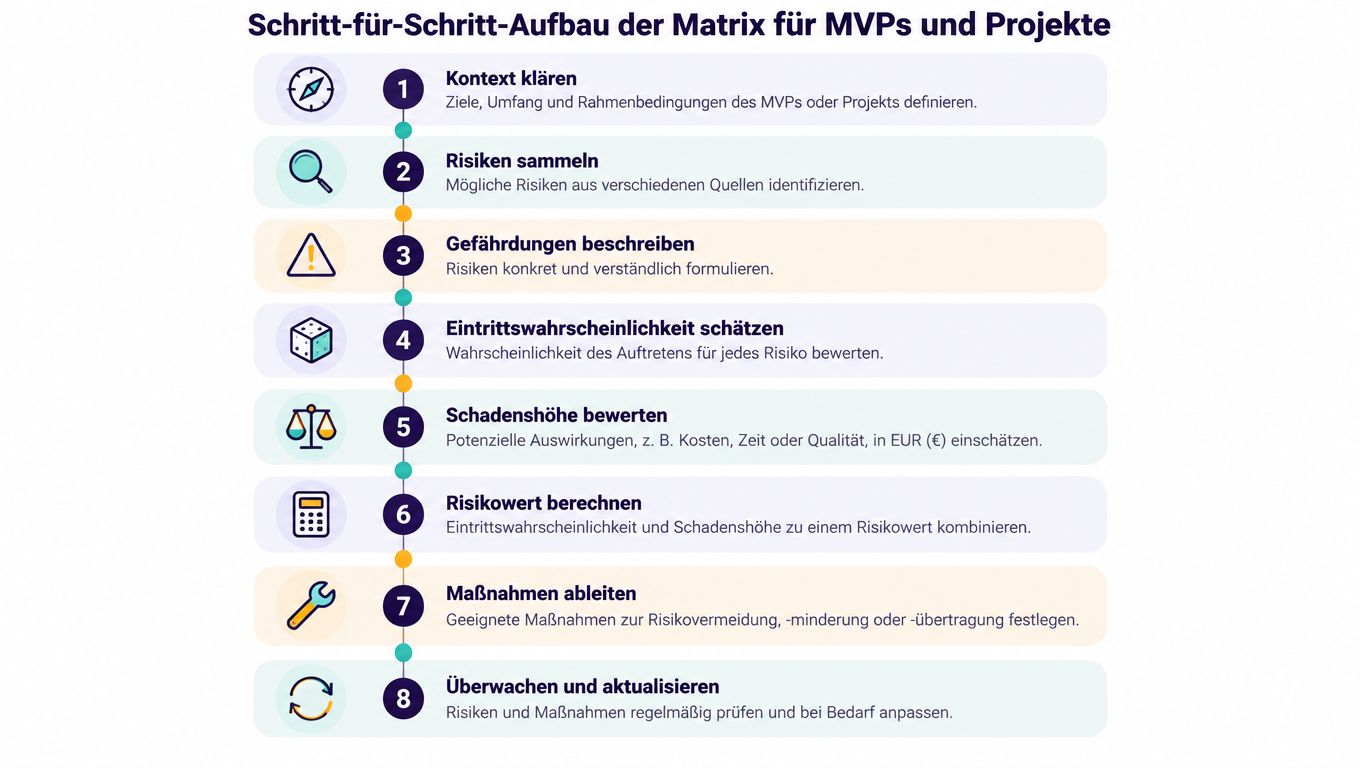
Die acht Schritte lauten in der Praxis: Kontext klären, Risiken sammeln, Gefährdungen beschreiben, Eintrittswahrscheinlichkeit schätzen, Schadenshöhe bewerten, Risikowert berechnen, Maßnahmen ableiten, überwachen und aktualisieren. Für jedes Risiko gehören mindestens Szenario, Ursache, betroffene Ressource, Wahrscheinlichkeit und Schadensschwere in den Datensatz. Die BAuA nennt die Risikomatrix nach Nohl als mögliches Verfahren, schreibt sie aber nicht als einzig zulässige Methode vor. (BAuA zum Prozess der Gefährdungsbeurteilung)
Für Softwareteams wird das konkret, wenn ein Risiko nicht nur heißt „externer Entwickler fällt aus“, sondern sauber beschrieben ist. Dann stehen dort etwa die Abhängigkeit von einer Person, der betroffene Release-Zeitplan, der Codebereich und die Ersatzoption. Erst dadurch wird die Matrix anschlussfähig für Entscheidungen.
Ein nützlicher Minimaldatensatz pro Risiko ist:
Gerade bei MVPs hilft das, weil frühe Produktteams oft zwischen Geschwindigkeit und Stabilität abwägen. Ein sauber dokumentierter Risikopfad verhindert, dass jedes Problem ad hoc verhandelt wird. Wer zusätzlich über Priorisierung im Produktkontext nachdenkt, findet eine sinnvolle Ergänzung in der internen Orientierung zur MVP-Priorisierung sowie in einer externen Qualifikationsmatrix für Personaleinsatzplanung, wenn es um Teamverfügbarkeit und Skills geht.
Eine Matrix ohne Entscheidungsprotokoll bleibt eine Liste. Wert entsteht erst, wenn klar geregelt ist, was nach der Bewertung passiert und wer den nächsten Schritt auslöst. Für Tech-Teams sind vier Reaktionen praktikabel: akzeptieren, vermindern, übertragen oder vermeiden.
Im Alltag gehört das Risiko in denselben Arbeitsfluss wie Storys, Bugs und technische Schulden. In Jira kann ein Risiko als Ticket mit Owner, Fälligkeitsdatum und Kontrollindikator leben. In GitHub passt es in Architektur-PRs, wenn eine Änderung eine neue Abhängigkeit oder ein Deploy-Risiko erzeugt. In wöchentlichen Tech-Syncs geht es dann nicht um abstrakte Farben, sondern um offene Maßnahmen und Restgefahren.
Die unterversorgte Frage ist eine andere: Ab wann eskalieren wir? Wer Risiken als Tickets pflegt, sollte dabei dieselbe Logik anwenden wie bei der internen Orientierung zur Backlog-Priorisierung, damit Eskalationen und Sprintplanung zusammenpassen. Bei softwareintensiven KMU ist das besonders relevant, weil laut BSI rund 80 Prozent der gemeldeten Cyberangriffe im Berichtszeitraum 1. Juli 2024 bis 30. Juni 2025 auf KMU zielten, während deutsche KMU im Durchschnitt offenbar nur 56 Prozent der Basisanforderungen des BSI-CyberRisikoChecks erfüllen. (BSI-Lagebericht 2025)
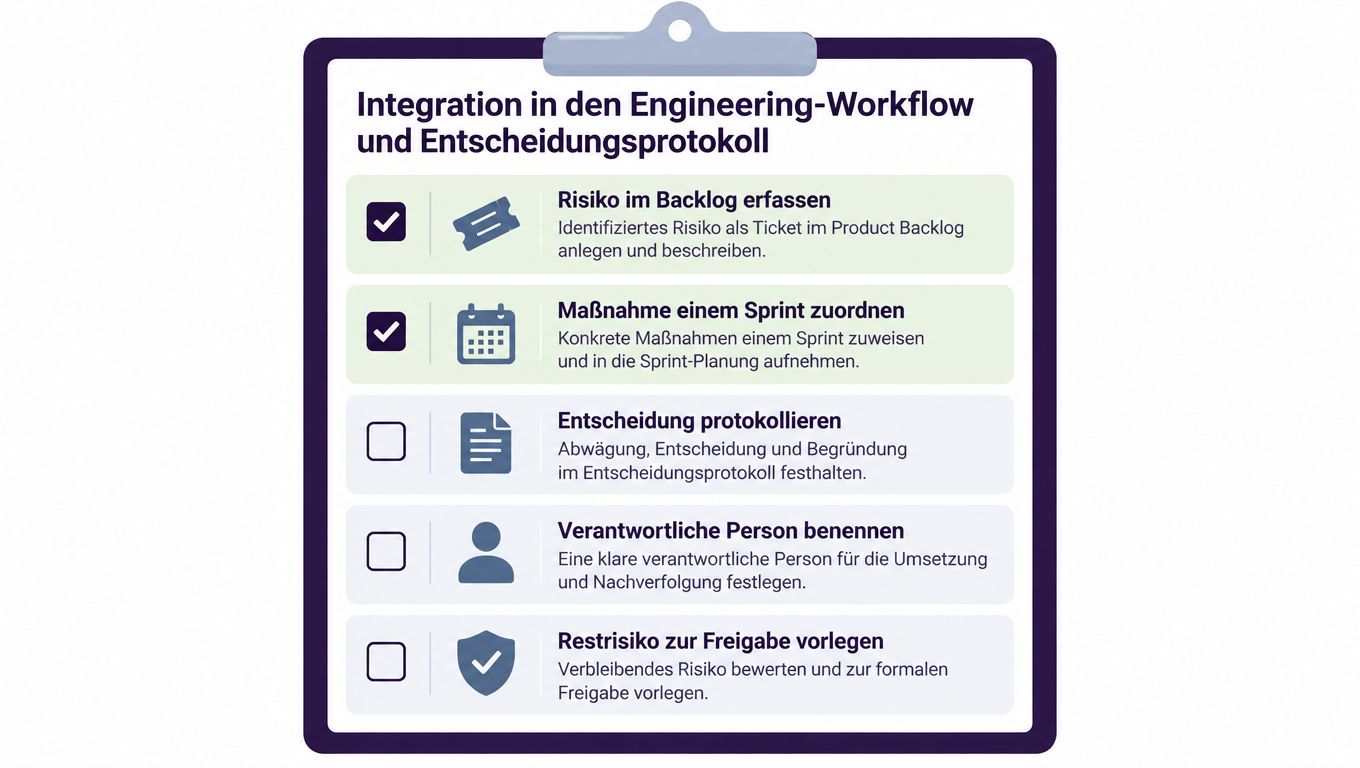
Ein gutes Protokoll beantwortet drei Fragen sofort:
Die Matrix sollte dabei nicht nur Verfügbarkeit abbilden. Datenschutz, Sicherheit, Lieferkette und Wissensrisiken brauchen getrennte Betrachtung, weil dieselbe Ursache mehrere Folgen haben kann. Wenn ein externer Dienst ausfällt, leidet oft nicht nur der Betrieb, sondern auch das Kundenvertrauen und unter Umständen die Datenverarbeitung.
Wenn eine Maßnahme abgeschlossen ist, wird das Risiko nicht geschlossen, sondern als Restrisiko neu bewertet.
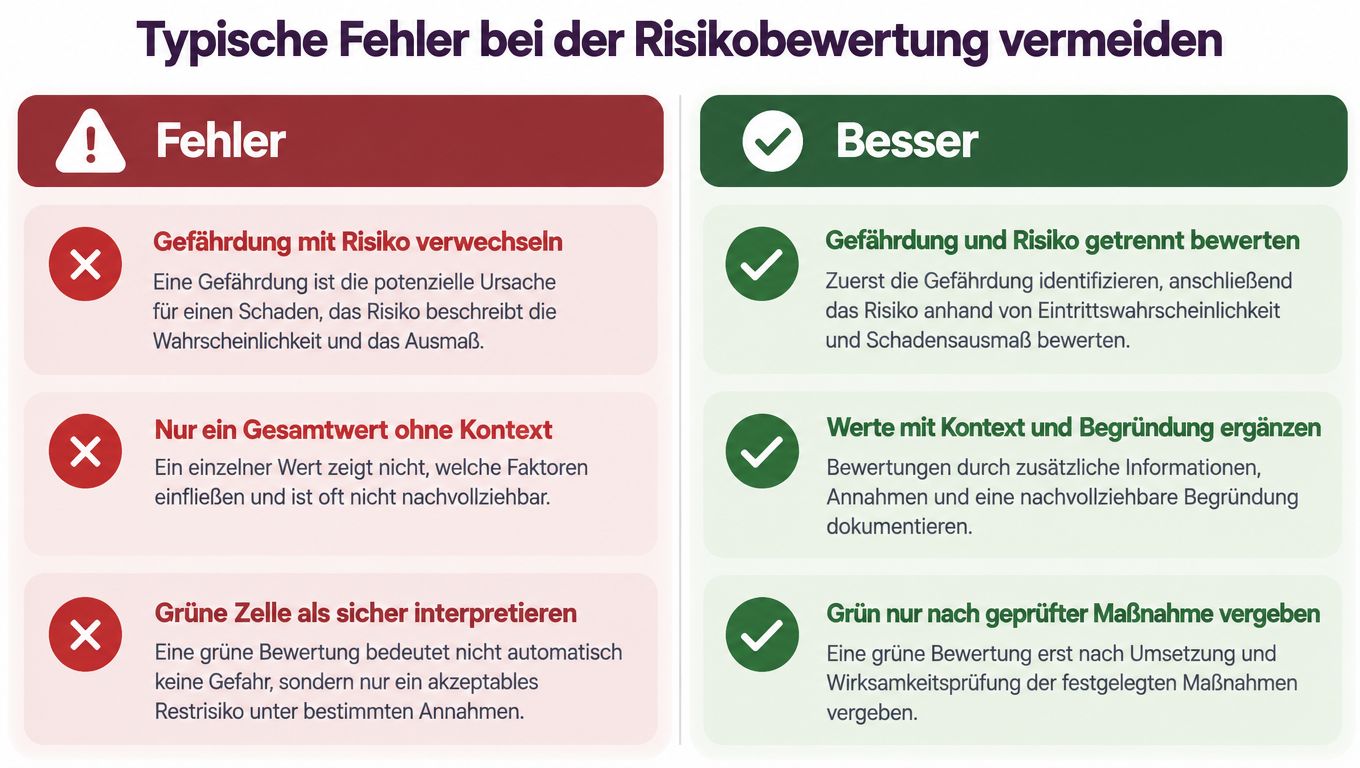
Für die Praxis heißt das, dass ein „grüner“ Status nie automatisch Freigabe bedeutet. Eine grüne Zelle ist nur dann akzeptabel, wenn die zugrunde liegende Maßnahme geprüft wurde und der Owner das Restniveau bewusst trägt. Genau an dieser Stelle verlieren viele Vorlagen ihren Wert, weil sie keine eindeutige Entscheidung erzwingen.
Die meisten Fehler in Risikomatrizen sind keine Rechenfehler, sondern Denkfehler. Teams verwechseln Gefährdung mit Risiko, füllen nur einen Gesamtwert ein oder behandeln eine grüne Zelle so, als wäre damit alles erledigt. Bei Software- und Lieferkettenrisiken rächt sich das schnell, weil mehrere moderate Probleme zusammen ein kritisches Bild ergeben können.
Eine 5x5-Matrix wirkt oft präziser, aber Präzision allein macht Entscheidungen nicht besser. Eine 3x3-Matrix kann in einem schnellen Produktteam nützlicher sein, wenn sie konsequent in Maßnahmen übersetzt wird. Die bessere Wahl ist die, die euer Team tatsächlich nutzt, nicht die mit der schönsten Farbpalette.
Das Problem ist die fehlende Kontexttiefe. Ein einzelner Wert ohne Szenario sagt nicht, ob es um einen kurzen Ausfall, eine Datenschutzverletzung oder technische Schuld geht. Wer Risiken sauber lesen will, braucht immer die Beschreibung daneben.
Die DGUV beschreibt Risiko ausdrücklich als Produkt aus Wahrscheinlichkeit und Folgen und nutzt Matrixgruppen zur Ableitung von Dringlichkeit und Reichweite der Maßnahmen. Für technische Sachverhalte empfiehlt die BAuA, qualitative Matrixverfahren bei komplexen oder sicherheitskritischen Themen durch analytische Verfahren wie Fehlerbaum- oder Ereignisablaufanalyse zu ergänzen. (DGUV zur Risikobewertung)
Am Ende zählt die Fähigkeit, zusammenhängende Risiken zu erkennen. Das höchste Risiko ist nicht immer das mit der höchsten Einzelpunktzahl, sondern oft die Kombination mehrerer mittlerer Risiken mit gemeinsamer Ursache. Deshalb gehören Abhängigkeiten in jedes Register, das mehr sein will als eine Momentaufnahme.
Statische Reviews sind für Cloud- und Open-Source-Umgebungen zu träge. Wenn sich Dienstleister, Bibliotheken oder Schwachstellen ständig ändern, veraltet eine quartalsweise Matrix schneller, als viele Teams nachziehen können. Das bessere Modell ist ein lebendes Risikoregister mit klaren Triggern.
Die Neubewertung sollte nicht an einen festen Termin gebunden sein, sondern an ein Ereignis. Ein Wechsel des Anbieters, eine kritische CVE, eine Änderung der Datenverarbeitung, ein Produktionsincident oder eine größere Architekturänderung sind alles valide Auslöser. Wer diese Trigger sauber definiert, macht die Matrix handlungsfähig.
Genau hier liegen die typischen Themen aus dem Alltag, etwa bei Security-Testing, wie es auch im Kontext von Security Testing in Entwicklungsprozessen relevant wird. Der Punkt ist nicht, jede Abweichung zu formalisieren, sondern die wenigen Ereignisse festzulegen, die eine echte Neubewertung verlangen.
Ein lebendes Register braucht außerdem messbare Frühindikatoren. Das können wiederkehrende Fehlerbilder, offene Patches, ungeklärte Abhängigkeiten oder ausbleibende Reaktionen von Dienstleistern sein. So bleibt die Matrix näher an der Realität eines laufenden Systems und entfernt sich von der Logik eines Jahresberichts.
Eine gute Matrix altert nicht im Kalender, sondern mit dem Produkt.
Wer Software baut, sollte deshalb auf eine Kombination aus Risiko, Ownership und Abhängigkeitskarte setzen. Dann wird die Matrix nicht zu einem Formular für den Ordner, sondern zu einem Steuerungsinstrument für den nächsten Release, den nächsten Incident und die nächste Architekturentscheidung.
PandaNerds unterstützt Teams dabei, Software-Risiken nicht nur zu dokumentieren, sondern im Entwicklungsalltag wirklich zu steuern. Wenn ihr eure Risk Assessment Matrix mit Engineering-Workflows, sauberem Ownership und praxistauglicher Priorisierung verbinden wollt, schaut euch PandaNerds an und prüft, wie sich eure nächste Produktphase belastbarer aufsetzen lässt.