02.07.2025
Asana vs. Trello: Welches Projektmanagement-Tool ist besser?
Asana vs. Trello: Welches Projektmanagement-Tool ist besser? Wir vergleichen beide Tools im Projektmanagement. Welches Tool passt besser zu Ihren Zielen?
get started


Gestern lief der Release sauber durch. Heute Morgen melden Support, Vertrieb und Monitoring gleichzeitig Probleme. Die App ist eigentlich gesund, aber ein DNS-Änderungssatz hängt in Caches fest, ein NS-Eintrag zeigt ins Leere, und plötzlich wirkt eure Plattform kaputt, obwohl Compute, Datenbank und CDN laufen.
Genau deshalb ist DNS Management kein Nebenschauplatz für den Registrar-Zugang und auch kein Thema, das man ans Infrastrukturteam „mit erledigen“ lässt. Wer Domains, Zonen, Delegation, Signierung, Monitoring und Provider-Wechsel nicht als zusammenhängendes Betriebssystem behandelt, baut sich stille Ausfallrisiken. Für CTOs ist das kein Detailthema, sondern eine Frage von Verfügbarkeit, Sicherheitsniveau, Compliance und Kontrollfähigkeit.
In Deutschland ist die Sache noch klarer. Das BSI verlangt für den Betrieb, dass genutzte Domains regelmässig und rechtzeitig verlängert werden, dass eine eindeutig verantwortliche Person für die Domainverwaltung benannt ist und dass bei ausgelagerter Verwaltung die Kontrolle über die Domains bei der Institution bleibt. Genau diese Punkte adressieren typische operative Ausfälle wie abgelaufene Registrierungen, fehlerhafte Delegationen oder verlorene Registrar-Kontrolle, wie der BSI-Grundschutz für DNS-Server festhält.
Viele Teams behandeln DNS noch immer wie eine statische Textdatei. Ein paar Records, ein TTL-Wert, fertig. Das war vielleicht einmal praktikabel. Heute hängt an DNS aber deutlich mehr: Authoritative Provider mit APIs, Anycast-Netze, DNSSEC-Validierung, Zertifikats-Automation, Health-Checks und Drift-Kontrolle zwischen Soll- und Ist-Zustand.
Wer nur auf Zone-Files schaut, blendet die eigentliche Betriebsrealität aus. DNS entscheidet, ob Nutzer euren Shop, eure API, euer Login und eure Mail-Infrastruktur überhaupt erreichen. Es entscheidet auch, ob eine Migration kontrolliert verläuft oder im Resolver-Chaos endet.
Eine Zone ist der Verwaltungsbereich für eine Domain oder Subdomain. Ein Record beschreibt, wie ein Name aufgelöst oder behandelt wird. Die TTL steuert, wie lange Resolver Antworten im Cache behalten. Genau diese TTL ist der Grund, warum Änderungen selten sofort sichtbar sind. Laut der Erklärung zur DNS-Propagation bestimmt die TTL die Cache-Dauer in Sekunden, während Resolver, ISPs, Browser und lokale Netze Antworten zusätzlich zwischenspeichern können. Deshalb sehen Teams Änderungen zeitversetzt und oft uneinheitlich über Netze hinweg, wie diese Darstellung der TTL- und Cache-Mechanik beschreibt.
DNS-Ausfälle entstehen oft nicht im Protokoll, sondern im Betriebsmodell.
Für CTOs zählen vier Dinge:
In Deutschland ist DNS längst Teil einer professionellen Registry-Infrastruktur. Die Verwaltung von .de begann 1986 mit dem Eintrag in die IANA-Datenbank, 1996 entstand die DENIC eG aus 37 deutschen Internet Service Providern, 1997 nahm die Geschäftsstelle in Frankfurt am Main den Betrieb auf und 1999 übernahm DENIC die technische Domainverwaltung vollständig. Parallel skalierten die Registrierungszahlen deutlich: 1 Million .de-Domains im Jahr 1999, 10 Millionen im Jahr 2006 und 16 Millionen im Jahr 2015, wie die DENIC-Historie dokumentiert. Das ist kein Hobby-System. Es ist kritische Infrastruktur.
Wer DNS im Alltag betreibt, braucht kein akademisches Modell. Er braucht ein sauberes Verständnis der Record-Typen, die in fast jeder Plattform vorkommen. Sobald dieses Fundament fehlt, wird jede Migration unnötig riskant.
| Record-Typ | Zweck | Beispiel |
|---|---|---|
| A | Verweist einen Hostnamen auf eine IPv4-Zieladresse | Shop-Frontend |
| AAAA | Verweist einen Hostnamen auf eine IPv6-Zieladresse | API über IPv6 |
| CNAME | Alias auf einen anderen Hostnamen | www auf Hauptnamen |
| MX | Zustellung von E-Mails | Firmenmail |
| TXT | SPF, DKIM, Verifikationen und Ownership-Nachweise | Mail-Schutz und SaaS-Verifikation |
| NS | Delegation an autoritative Nameserver | Subdomain an anderen Provider |
Ein A-Record oder AAAA-Record ist meist der nüchternste Teil. Frontend, API oder ein dedizierter Dienstname zeigen auf das Zielsystem. Der CNAME ist nützlich für Aliase, etwa wenn www auf den primären Hostnamen zeigen soll. MX-Records steuern Mailzustellung. TXT-Records landen schnell überall, weil SPF, DKIM, Domain-Ownership und diverse SaaS-Integrationen daran hängen.
Die gefährlichsten Missverständnisse entstehen bei NS-Records. Sie regeln nicht den Inhalt einer Zone, sondern deren Delegation.
Viele Teams werfen Delegation und Authoritative DNS in einen Topf. Das ist ein Fehler.
Wenn ihr etwa eine Subdomain an einen anderen Provider abgebt, dann reicht ein sauberer Zoneninhalt dort nicht aus. Die Parent-Zone muss korrekt delegieren. Sonst beantwortet niemand die Anfragen sinnvoll.
TTL ist eine Steuergrösse. Kurze TTLs helfen vor Migrationen, Failover oder kontrollierten Umschaltungen. Längere TTLs reduzieren Last und unnötige Auflösungsvorgänge. Wer immer nur niedrige Werte setzt, handelt sich mehr Betriebsrauschen ein. Wer immer nur hohe Werte setzt, blockiert Änderungen.
Der SOA-Record wird oft ignoriert, obwohl er zentrale Metadaten der Zone enthält, etwa Seriennummer sowie Parameter für Refresh und Retry. Das ist keine Deko. Diese Angaben wirken sich auf Synchronisation und Betriebsverhalten aus.
Praktische Regel: Pflegt Records nie parallel per Hand in Test, Staging und Produktion. DNS ohne eine führende Quelle driftet zwangsläufig auseinander.
Ein minimales Zonenmodell ist hilfreich, aber der eigentliche Punkt ist wichtiger: Behandelt Record-Sets als versionierte Einheiten. Nicht als Klickstrecke in mehreren Web-UIs.
Bei Authoritative DNS gibt es kein universell bestes Modell. Es gibt nur passende und unpassende Modelle für euer Risikoprofil. Die falsche Architektur merkt man selten im Normalbetrieb. Man merkt sie bei Audit, Migration, Incident oder Akquisition.
| Muster | Ausfallrisiko | Latenz global | Betriebsaufwand | Typischer Einsatz |
|---|---|---|---|---|
| Anycast bei Cloud-DNS-Anbieter | Niedrig bei gutem Provider, aber Abhängigkeit vom Anbieter | Sehr gut | Niedrig bis mittel | Startups, SaaS, global erreichbare Plattformen |
| Primary und Secondary mit zwei autoritativen Servern | Gut bei sauberem Betrieb, aber intern verantwortet | Gut | Hoch | Regulierte Umgebungen, hohe Kontrollanforderung |
| Split-Horizon | Beherrschbar, aber fehleranfällig bei Komplexität | Abhängig vom externen Teil | Hoch | Enterprise-Netzwerke mit internem und externem Namensraum |
Anycast-DNS beim Managed Provider ist meist die pragmatische Wahl. Ihr bekommt globale Erreichbarkeit, stabile Edges und eine API. Der Preis dafür ist Abhängigkeit von der Control Plane des Anbieters. Wenn dessen API hakt oder das Produktmodell nicht zu eurem Workflow passt, wird jede Änderung zäh.
Primary/Secondary mit eigener Autorität, etwa mit BIND und Knot sowie abgesicherter Zonensynchronisation, gibt euch maximale Kontrolle. Das Modell passt, wenn Compliance, Nachvollziehbarkeit und interne Sicherheitsvorgaben schwerer wiegen als Bequemlichkeit. Ihr kauft diese Kontrolle aber mit Betriebsaufwand.
Split-Horizon ist in grossen Organisationen oft nicht optional. Interne Systeme brauchen andere Antworten als externe Clients. Das funktioniert, erhöht aber die Fehlerquote bei Zertifikats-Automation, ACME-Challenges, Troubleshooting und Onboarding neuer Teams.
Ein Architekturmuster bleibt selten dauerhaft passend. Typische Wechseltrigger sind:
Meine klare Meinung: Kleine und mittlere Produktteams sollten mit einem starken Managed-DNS-Setup starten. Regulierte Branchen und komplexe Enterprise-Umgebungen brauchen früher oder später mehr Kontrolle, mehr Trennung und sauber dokumentierte Autorität.
Die meisten DNS-Provider werden über Features verkauft. Das ist die falsche Perspektive. Entscheidend ist, ob der Anbieter euer Betriebsmodell unterstützt. Wer nur Preise und UI vergleicht, sucht an der falschen Stelle.
| Kriterium | Startup | Mittelstand (DACH) | Enterprise |
|---|---|---|---|
| API- und Terraform-Reife | Muss vollständig sein | Muss vollständig und stabil sein | Muss vollständig, stabil und auditierbar sein |
| DNSSEC-Support | Sollte ohne Workarounds gehen | Muss produktionsreif sein | Muss mit klaren Betriebsprozessen integrierbar sein |
| Audit-Logging | Sinnvoll | Wichtig | Pflicht |
| EU-Datenresidenz | Je nach Kundenprofil | Relevant | Meist verbindlich |
| Exit-Strategie | Oft übersehen, aber wichtig | Muss dokumentiert sein | Muss getestet sein |
| Secondary-DNS-Fähigkeit | Optional | Empfehlenswert | Häufig erforderlich |
Drei Kriterien gewichte ich am höchsten:
Automatisierbarkeit
Wenn API und Terraform nur die Hälfte des Produkts abdecken, lasst es. DNS ohne vollständige IaC-Unterstützung skaliert schlecht.
Kontrollierbarer Sicherheitsbetrieb
DNSSEC darf kein Sonderfall sein. Logging, Rollback, Record-Historie und nachvollziehbare Änderungen gehören dazu.
Exit-Fähigkeit
Fragt vor Vertragsabschluss, wie Export, Provider-Wechsel und Parallelbetrieb aussehen. Wenn diese Antwort schwammig ist, ist der Provider zu klebrig.
Für ein Startup mit unter 50 Mitarbeitenden empfehle ich einen Managed-Authoritative-DNS-Anbieter mit sauberer API, guter Terraform-Unterstützung und einfacher DNSSEC-Aktivierung. Das Team braucht Geschwindigkeit, keine selbstgebaute DNS-Plattform.
Im Mittelstand mit DACH-Fokus sollten Logging, sekundäre Betriebsoptionen, klare Rollen und europäische Betriebsanforderungen stärker gewichtet werden. Wer Infrastruktur ohnehin in der Cloud betreibt, sollte DNS-Auswahl nicht isoliert treffen. Die Architektur von Hosting, Netzwerk und DNS muss zusammenpassen. Genau deshalb lohnt sich der Blick auf typische Betriebsmodelle wie Web-Hosting in AWS, bevor man den DNS-Provider festzurrt.
Im Konzern mit Compliance-Last ist ein Enterprise-Modell mit klarer Control Plane, Rollenmodell, Audit-Spur und belastbarer Exit-Strategie meist die richtige Wahl. Hier gewinnt nicht der billigste Anbieter, sondern der, den ihr in Incident, Audit und Migrationsphase beherrscht.
Wenn DNS noch per Web-UI gepflegt wird, habt ihr kein belastbares Betriebsmodell. Ihr habt manuelle Zustandsänderung ohne echte Review-Kette. Das mag für eine Microsite reichen. Für produktive Plattformen reicht es nicht.
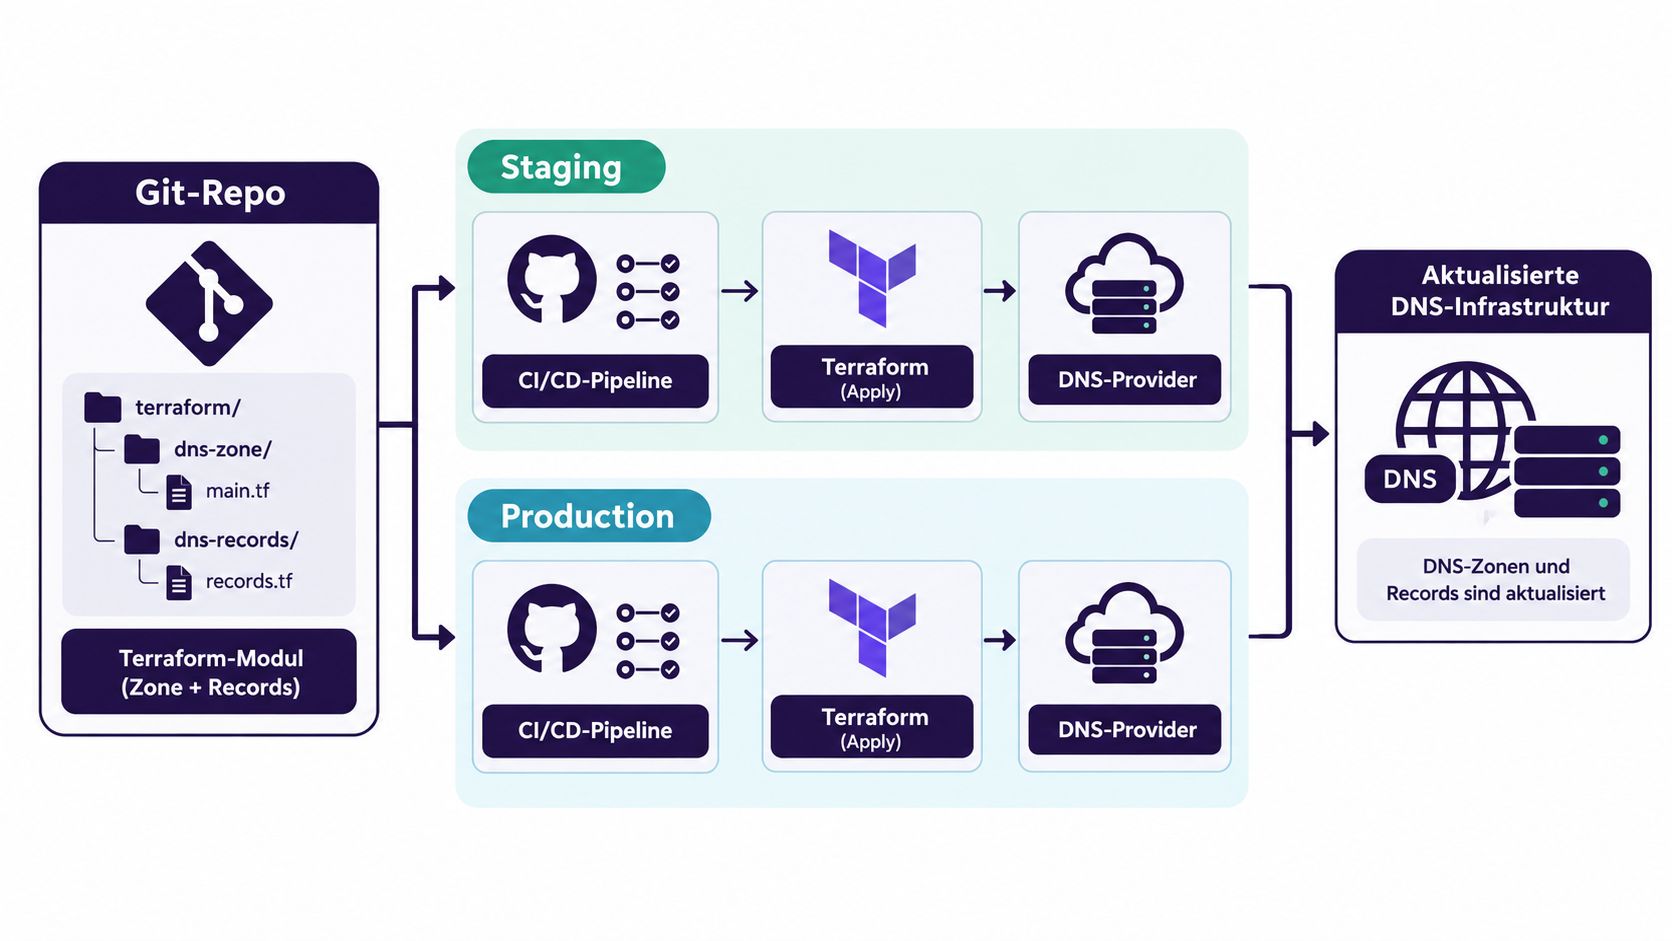
Der saubere Weg ist simpel:
Das Modell ist nicht kompliziert. Es ist diszipliniert. Genau das fehlt in vielen Teams.
Terraform passt gut, wenn ihr bereits stark mit deklarativer Infrastruktur arbeitet. Definiert A-, AAAA- und CNAME-Records als wiederverwendbare Module, parametrisiert TTLs sauber und kapselt sensible Einträge separat. Kritische Records wie Apex, MX oder zentrale Verifikationen sollten gegen versehentliche Änderungen organisatorisch und technisch geschützt werden.
Pulumi ist eine gute Alternative, wenn euer Plattform-Stack stark von TypeScript geprägt ist. Dann könnt ihr DNS näher an bestehende Engineering-Konventionen ziehen, ohne in ein zweites System zu kippen. Entscheidend ist nicht das Tool. Entscheidend ist, dass DNS denselben Qualitätsstandard bekommt wie Compute, Netzwerk und Deployments.
Für Teams, die CI/CD noch nicht konsequent im Infrastrukturkontext nutzen, ist ein sauberer Einstieg über Continuous Integration im Engineering-Alltag sinnvoll. DNS profitiert davon besonders stark, weil kleine Änderungen grosse Reichweite haben.
Viele Teams führen IaC ein und glauben dann, das Problem sei gelöst. Ist es nicht. Sobald jemand doch im Provider-UI klickt, driftet der Live-Zustand vom Repo weg.
Sinnvoll sind deshalb drei zusätzliche Regeln:
plan in einer PipelineWenn Marketing, Engineering und Legal dieselbe Domain verwalten, aber niemand das führende System benennt, endet das in toten Records, verlorenen Verifikationen und schiefen Migrationen.
DNS-Sicherheit scheitert oft daran, dass Teams Einzelmassnahmen isoliert betrachten. DNSSEC wird aktiviert, aber Resolver validieren nicht sauber. DoH wird diskutiert, aber ohne klare Betriebsziele. DDoS-Schutz wird beim Provider vermutet, aber nie überprüft. So baut man Lücken.
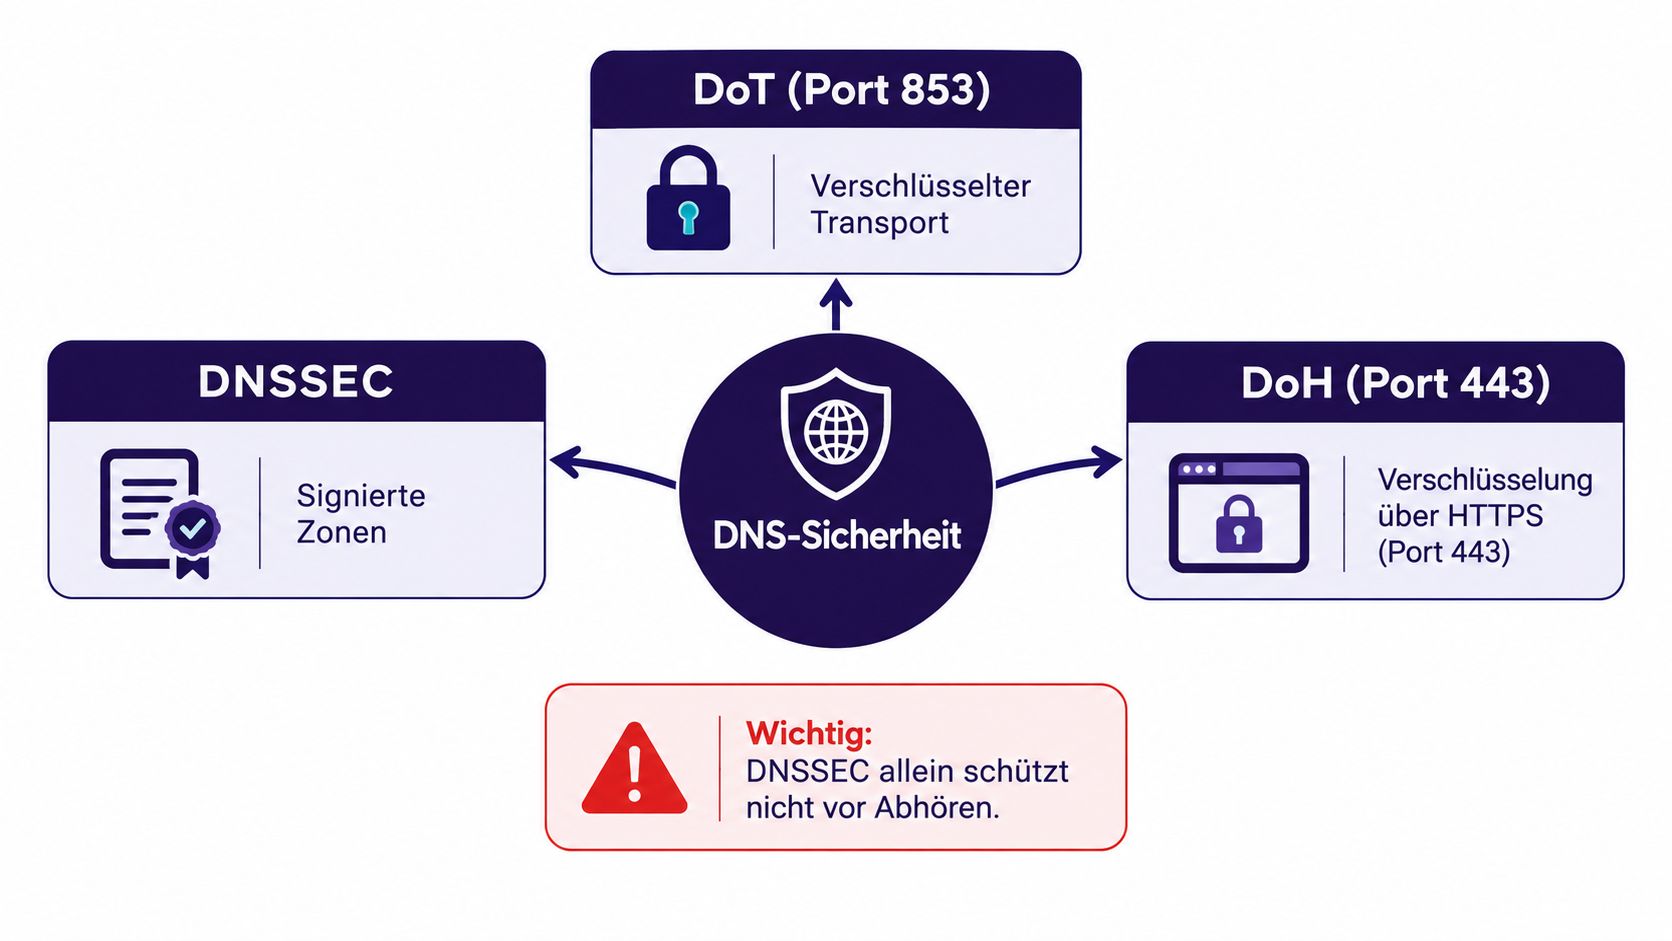
DNSSEC schützt die Integrität von DNS-Antworten. Signaturen erlauben Resolvern zu prüfen, ob Antworten echt und unverändert sind. DENIC beschreibt DNSSEC für .de ausdrücklich als Schutz gegen DNS-Manipulation und dokumentiert die signierte .de-Zone sowie die Validierung über den DS-Record in der Rootzone. Ein korrekt konfigurierter Validierungs-Resolver verwirft Antworten bei Signaturfehlern, statt sie ungeprüft auszuliefern, wie im DENIC-Beitrag zur DNSSEC-Störung bei .de-Domains erläutert wird.
DoT und DoH lösen ein anderes Problem. Sie schützen den Transportweg der Abfrage, nicht die Authentizität des Inhalts. Verschlüsselung hilft gegen Mitlesen und Manipulation auf dem Transportpfad. Ohne DNSSEC bleibt aber die Vertrauensfrage zur Antwort selbst unvollständig.
Deutschland zählt bei der DNSSEC-Nutzung zu den führenden Ländern Europas. Eine JRC-Auswertung der EU-Kommission weist für Deutschland eine DNSSEC-Validierungsrate von 81,14 Prozent aus. In einer neueren JRC-Studie liegt Deutschland erneut über der 70-Prozent-Marke und wird zusammen mit Dänemark, Finnland, Luxemburg, Schweden und Tschechien als Spitzengruppe genannt. Die APNIC-Karte für Europa zeigt zudem einen europäischen Durchschnitt von 58,84 Prozent, während Dänemark 96,19 Prozent erreicht. Deutschland liegt damit klar im oberen Segment, wie die JRC-Auswertung zur DNSSEC-Verbreitung zeigt.
Das kommt nicht von ungefähr. DENIC führte DNSSEC für die .de-Zone bereits 2011 ein, und ein gemeinsames Testfeld von BSI, DENIC und eco machte DNSSEC für .de schon 2010 verfügbar. Gleichzeitig lag der Anteil signierter .de-Domains Anfang 2015 laut BSI erst bei 0,25 Prozent, wie der BSI-Bericht zur IT-Sicherheitslage 2015 festhält. Die Lehre ist simpel: technische Verfügbarkeit allein bringt keine Adoption. Betrieb, Automatisierung und Ownership bringen sie.
Ein guter technischer Einstieg in angrenzende Schutzmechanismen ist regelmässiges Security Testing im Plattformbetrieb.
Dieses Video ist eine brauchbare Ergänzung, wenn ihr das Thema intern erklären oder im Team diskutieren wollt.
Wer DNSSEC einführt, muss KSK- und ZSK-Management, automatischen Key-Rollover, DS-Record-Eintrag bei der Registry und laufende Validierungschecks als einen Prozess betrachten. Das BSI stellt dafür konkrete Betriebs- und Einrichtungsleitlinien bereit und empfiehlt DNSSEC auch für sicherheitsrelevante E-Mail- und Internet-Setups in der BSI-Dokumentation zur Umsetzung von DNSSEC.
Dazu kommt die Resilienzschicht. Das Thema ist akut: Laut einem aktuellen deutschen Fachbericht machten DNS-Floods im zweiten Quartal 2026 40 Prozent aller Angriffe auf der Netzwerkebene aus, und rund 80 Prozent aller DNS-Anfragen betreffen Domains ohne DNSSEC-Signatur, wie der BSI-CS-Bericht zu DNS-Sicherheit und kritischer Infrastruktur zusammenfasst. Deshalb gehören Response-Rate-Limiting, georedundanter Betrieb, Vorfallprozesse und ein realistisches DDoS-Modell zwingend dazu.
Viele Teams messen DNS falsch. Ein einzelner Uptime-Check gegen die Website ist kein DNS-Monitoring. Er sagt euch nur, dass aus genau dieser Perspektive gerade irgendetwas antwortet. Mehr nicht.
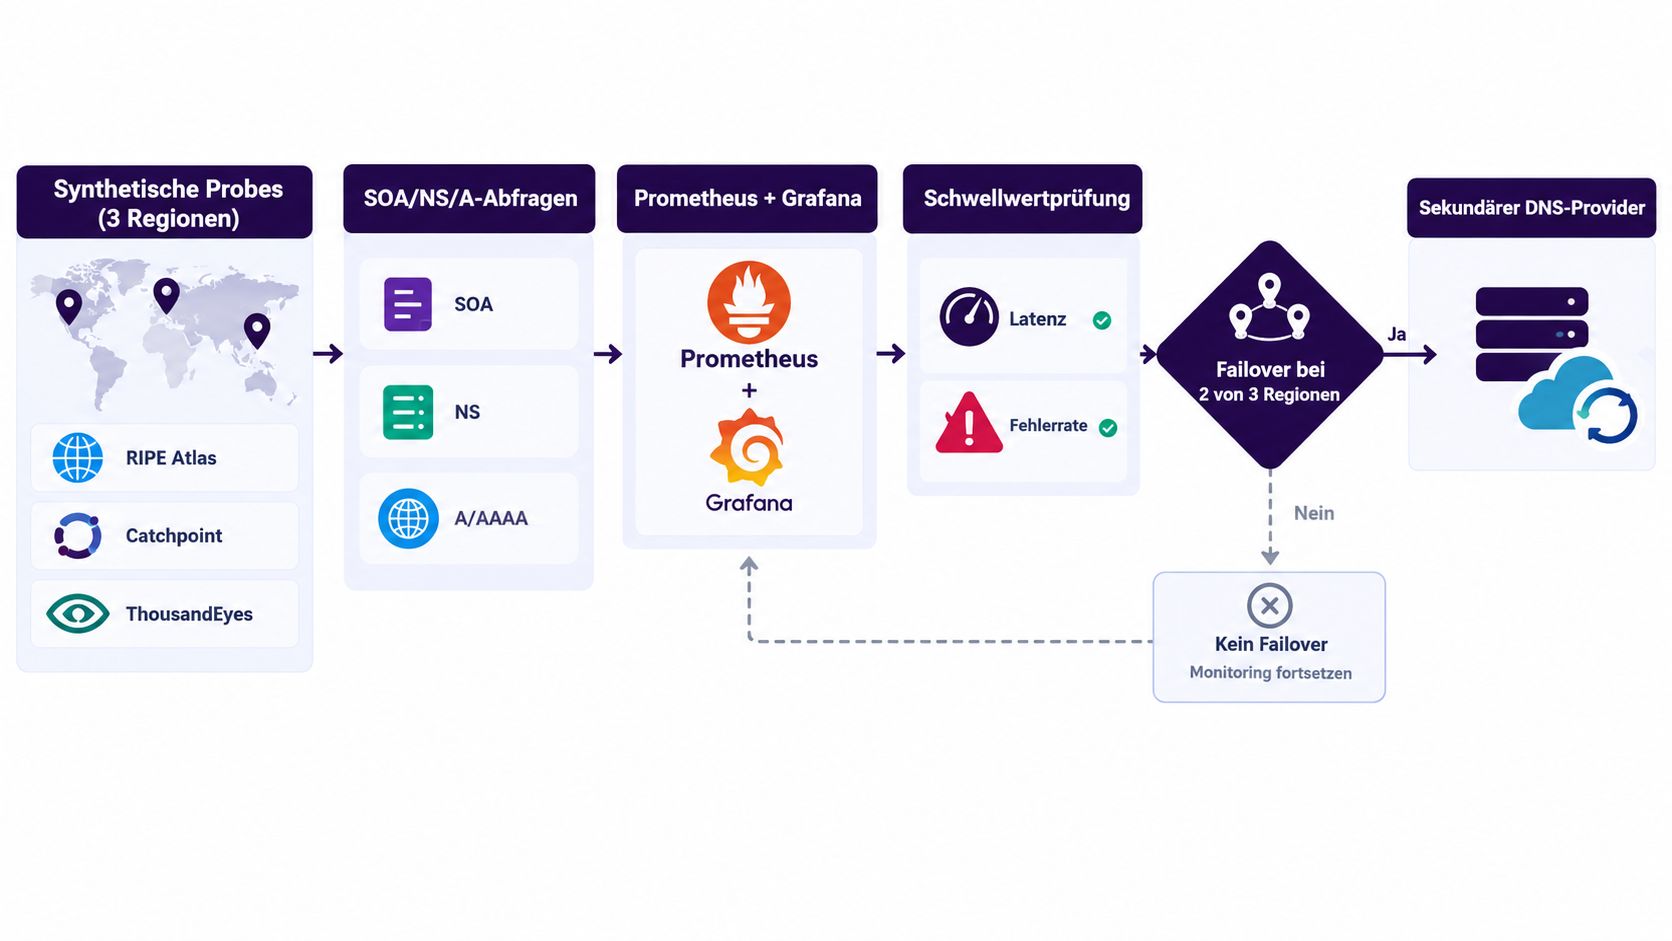
Ein brauchbares Setup kombiniert zwei Ebenen:
Synthetische DNS-Probes
Fragt aus mehreren Regionen gezielt SOA-, NS- und kritische A- oder AAAA-Records gegen unterschiedliche Resolver ab.
Service-Health hinter DNS
Prüft HTTP-Status, TLS-Handshake, Zertifikatslaufzeit und die Erreichbarkeit der eigentlichen Anwendung.
Tools wie RIPE Atlas, Catchpoint, ThousandEyes, Prometheus und Grafana passen hier gut zusammen. Nicht jedes Team braucht die gesamte Werkzeugkette. Jedes Team braucht aber mehrere Perspektiven auf denselben Namen.
Nicht jedes Problem verdient dieselbe Eskalation. Ich empfehle eine harte Priorisierung:
Ein DNS-Failover, das bei einem einzelnen Messfehler umschaltet, ist kein Resilienzmechanismus. Es ist ein Störgenerator.
Failover-Strategien unterscheiden sich deutlich:
| Ansatz | Charakter | Wann sinnvoll |
|---|---|---|
| Aktives Traffic-Management | GeoDNS, gewichtete Records, Integration in Load-Balancing | Mehrere Regionen, klare Routing-Logik |
| Passives Reserve-Setup | Sekundärer Anbieter als Bereitschaft | Höhere Sicherheit gegen Provider-Ausfall |
| Kaltes Fallback | Dokumentiertes Umschalten im Incident | Für weniger dynamische Umgebungen |
Wichtig ist die Logik hinter dem Umschalten. Ein Trigger sollte nur greifen, wenn Ausfälle konsistent aus mehreren Regionen sichtbar sind und nicht nur aus einem einzelnen vantage point. Dokumentiert ausserdem RTO und RPO pro Domain-Klasse. Marketing-Landingpages, Kundenportal, API und Mail-Domains haben nicht denselben Schadensradius.
Und testet Failover regelmässig. Nicht theoretisch. Praktisch, kontrolliert und mit Runbook.
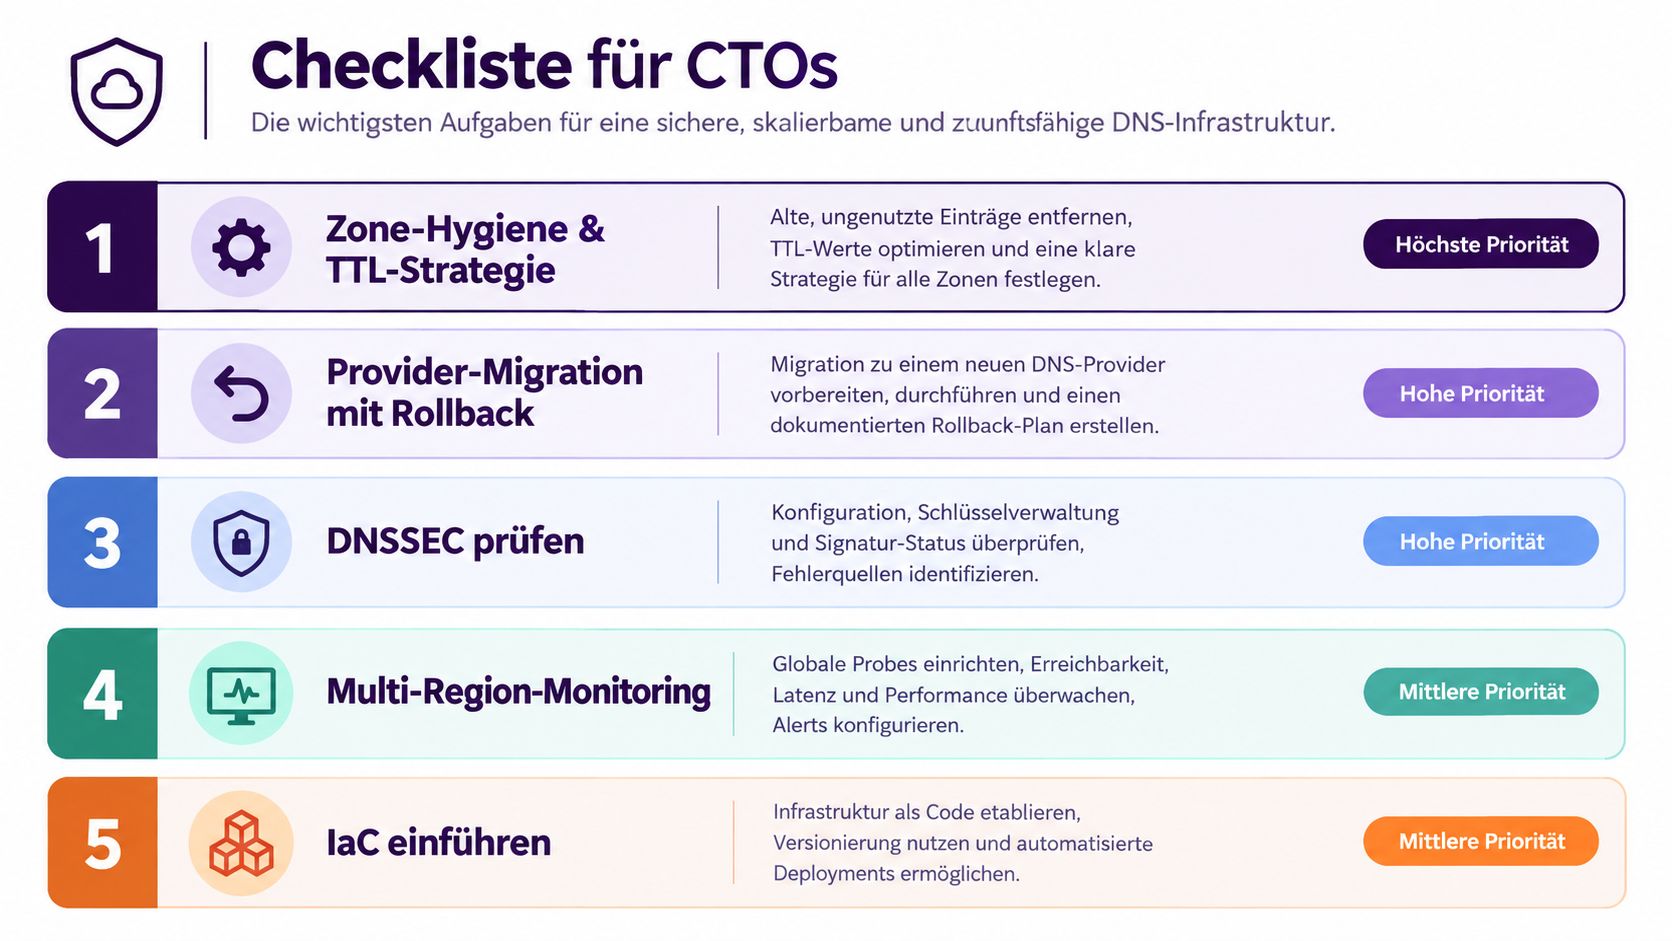
Wenn euer DNS gerade historisch gewachsen ist, braucht ihr keine Perfektion als Erstes. Ihr braucht Reihenfolge. Fangt mit den Themen an, die Ausfälle und Kontrollverlust am direktesten verhindern.
Sofort am Tag 1
Legt Ownership fest. Eine benannte verantwortliche Person für Domainverwaltung ist kein Nice-to-have, sondern entspricht auch den BSI-Anforderungen aus dem früher verlinkten Grundschutz. Prüft ausserdem Domainlaufzeiten, Registrar-Zugänge, NS-Delegationen und besonders kritische Zonen.
Kurzfristig in Woche 1 bis 4
Definiert eine TTL-Strategie pro Domain-Klasse. Plant Provider-Wechsel nur mit dokumentiertem Rollback. Führt ein zentrales Inventar für Domains, Subdomains und externe SaaS-Verifikationen.
Mittelfristig im Quartal
Führt IaC für DNS ein. Trennt Zuständigkeiten sauber. Aktiviert DNSSEC dort, wo die Plattform und die Prozesse es zuverlässig tragen.
Laufend im Betrieb
Etabliert Multi-Region-Monitoring, Drift-Erkennung, Signaturkontrollen und regelmässige Failover-Tests.
Einige Fehler sehe ich in Migrationen ständig wieder:
Single Point of Failure beim Provider
Teams glauben, der DNS-Anbieter selbst sei schon genug Redundanz. Ist er nicht zwangsläufig. Ohne Sekundärstrategie hängt zu viel an einem Vertrag, einer API und einer Control Plane.
Zu hohe TTLs vor Änderungen
Wer Migrationen mit starren Cache-Zeiten startet, verliert Steuerbarkeit.
Nicht atomare Providerwechsel
Wenn Zoneninhalt, Delegation und Validierung unsauber koordiniert sind, entstehen Split-Brain-Effekte.
Vergessene DNSSEC-Pflege
Signierung ist kein Einmalprojekt. Schlüssel, DS-Kette und Validierung brauchen Betrieb.
Keine Runbooks
Ohne dokumentierte Schritte verlängert sich jeder Incident. Nicht weil DNS kompliziert wäre, sondern weil niemand im Stress weiss, wer was wann ändert.
Euer Job ist nicht, jeden Record selbst zu kennen. Euer Job ist, ein System zu schaffen, in dem DNS nicht von Zufall, Personenwissen oder Panel-Klicks abhängt.
Dazu gehört auch der Blick auf die Marktreife von .de. Aktuell sind 17,7 Millionen .de-Domains registriert. Damit liegt .de weltweit auf Platz 3 nach .com und .cn und bei rund 21.150 Domains pro 100.000 Einwohnern. Gleichzeitig ist das jährliche Wachstum zuletzt leicht um 0,35 Prozent zurückgegangen, von 15.551.210 auf 15.496.399 registrierte Domains im Inland, wie die Analyse zum deutschen Domainmarkt 2026 zusammenfasst. Genau diese Reife verführt viele Teams zur falschen Annahme, DNS sei „schon stabil genug“. In Wirklichkeit macht ein reifer Markt sauberes Record-Management, Delegationshygiene und Monitoring noch wichtiger.
Für NIS2-pflichtige oder nah daran operierende Unternehmen ist die Eskalation ebenfalls klar: Domainverantwortung, Resilienz, Vorfallprozesse und Nachvollziehbarkeit gehören in den regulären Plattformbetrieb. Nicht in eine Excel-Liste beim Office Management.
Wenn ihr DNS, Plattformbetrieb und Security nicht als getrennte Themen behandeln wollt, sondern als ein sauberes operatives System, ist genau das die Art von Arbeit, bei der wir unterstützen. PandaNerds hilft Teams dabei, erfahrene Engineers in bestehende Plattform-, Cloud- und Produktstrukturen einzubinden, damit Themen wie DNS-Automatisierung, Migrationen und betriebsfeste Infrastruktur nicht liegen bleiben. Schaut euch auf PandaNerds an, wie wir Engineering-Kapazität und technische Verantwortung pragmatisch zusammenbringen.