02.07.2025
Asana vs. Trello: Welches Projektmanagement-Tool ist besser?
Asana vs. Trello: Welches Projektmanagement-Tool ist besser? Wir vergleichen beide Tools im Projektmanagement. Welches Tool passt besser zu Ihren Zielen?
get started


Montagmorgen, 8:12 Uhr. Das B2B-Portal lädt plötzlich nicht mehr in unter einer Sekunde, sondern quält sich durch mehrere Sekunden, der Support läuft voll, und im Remote-Team rät ein Senior-Entwickler gerade, ob der Fehler im Deploy, in der Datenbank oder im CDN steckt. Genau in solchen Momenten zeigt sich, ob Performance Monitoring nur ein Dashboard mit hübschen Kurven ist oder eine verlässliche Betriebsdisziplin, die ein Team wirklich handlungsfähig macht.
In deutschen Umgebungen ist das Thema längst kein Randthema mehr. Der Markt für Application Performance Monitoring ist in Deutschland stark verankert, Deutschland hatte 2024 einen Anteil von 26,4 % am europäischen Markt für Application Performance Monitoring, und laut einer zitierten Auswertung des Bundesamts für Sicherheit in der Informationstechnik setzten bereits 73 % der DAX-30-Unternehmen 2023 erweitertes End-User-Monitoring ein, während deutsche Industrieunternehmen Performance Monitoring in 89 % ihrer cloudbasierten Produktionssteuerungssysteme nutzen (Market Data Forecast). Wer verteilte Teams, komplexe Releases und knappe Senior-Ressourcen zusammenbringen muss, braucht daher mehr als Tool-Bingo.
Wenn ein System kippt, kippt selten nur ein einzelner Bildschirm. Produkt, Engineering, Support und Management sehen dann dieselbe Lage mit unterschiedlichen Brillen, und ohne zentrale Telemetrie werden Entscheidungen langsam, defensiv und teuer. Genau deshalb entscheidet Performance Monitoring heute über Wettbewerbsfähigkeit, besonders in verteilten Teams, in denen nicht jeder dieselbe Maschine, dasselbe Netzwerk und denselben Wissensstand hat.
Der erste Baustein sind fundierte Metriken und SLAs, also sauber definierte Zielgrößen statt Bauchgefühl. Ohne diese Basis diskutiert man im Incident nur über Eindrücke, nicht über Prioritäten.
Der zweite Baustein ist eine saubere Architektur aus APM, Logs, Metriken und Tracing. Fehlt sie, sieht ein Team zwar Symptome, aber nicht die Ursache hinter einer langsamen Antwortzeit.
Der dritte Baustein ist eine Tool-Auswahl mit klaren Kriterien. Wer nur nach Funktionslisten einkauft, zementiert neue Silos, statt alte aufzulösen.
Der vierte Baustein ist eine schrittweise Einführung. Ohne Reihenfolge endet Monitoring schnell als Sammlung unverbundener Dashboards und Agenten.
Der fünfte Baustein sind Alerting und Runbooks. Fehlen sie, wird aus jeder Störung ein Ping-Pong zwischen On-Call, Produkt und Infra.
"Praktische Regel: Ein Monitoring-Setup ist dann brauchbar, wenn ein Remote-Senior-Entwickler den wahrscheinlichsten Engpass auch ohne physische Nähe zum Team in wenigen Minuten eingrenzen kann."
Deutschland hat für solche Disziplinen früh messbare Grundlagen gelegt. Schon 2006 stieg der ePerformanceIndex der deutschen Informationswirtschaft um 10,9 % auf 3.233 Punkte, und Deutschland lag damit erstmals über dem europäischen Durchschnitt (IZA-Bericht). Die Technik ist heute weiter, aber die Logik bleibt dieselbe, messen, vergleichen, entscheiden.
Ein Remote-Senior-Entwickler übernimmt einen Service, dessen Antwortzeit im Tagesverlauf stark schwankt. Ohne gemeinsame Zielwerte bleibt offen, ob eine Abweichung ein Incident, ein Skalierungsproblem oder noch akzeptable Betriebsvarianz ist. Metriken schaffen die Messbasis. SLIs bilden die Nutzerperspektive ab. SLOs legen interne Qualitätsziele fest. Error Budgets bestimmen, wie viel Abweichung ein Team für weitere Releases akzeptiert.
Ziele müssen vor der Messung feststehen. Eine deutsche Wissensquelle zu KPIs betont, dass Kennzahlen erst mit klar definierten Aktivitätszielen, strukturierter Datenerhebung und einem möglichst stabilen Berichtszeitraum belastbare Vergleiche ermöglichen (Research in Germany). Viele Teams sammeln dagegen erst Daten und entscheiden später, welche Handlung daraus folgen soll. Das erzeugt Dashboards, aber keine Steuerung.
Für den Betrieb reicht zunächst ein begrenzter Satz an Kernmetriken. Ein deutsches IT-Monitoring-Glossar nennt Verfügbarkeit, Reaktionszeit, Durchsatz, Fehlerrate und Ressourcenauslastung als typische Kennzahlen (QEDCON). Diese Auswahl bringt Produkt, Plattform und Betrieb auf dieselben Fragen. Vertiefende Ansätze beschreibt auch der Beitrag zur Performance-Optimierung.
SLAs und SLOs schaffen außerdem eine gemeinsame Verhandlungsbasis zwischen Entwicklung, Produkt und Management. Ohne sie werden Prioritäten leicht nach Lautstärke oder Status entschieden. Mit einem Error Budget lässt sich dagegen festlegen, wann weitere Releases vertretbar sind und wann Stabilisierung Vorrang erhält. Das hilft verteilten Teams, Entscheidungen asynchron nachzuvollziehen, statt sie in wiederholten Abstimmungsrunden neu auszuhandeln.
"Merksatz: Ein gutes SLO beantwortet nicht, ob ein System perfekt ist, sondern ob das Team mit der aktuellen Qualität weiter ausliefern darf."
Die vier Säulen gehören zusammen, aber sie lösen unterschiedliche Fragen. APM sagt, welcher Service langsam ist, Metriken zeigen den Verlauf über Zeit, Logs liefern Kontext pro Ereignis, und Tracing verbindet den Weg einer Anfrage über mehrere Services hinweg. Wer sie als Konkurrenzprodukte betrachtet, baut unnötige Doppelstrukturen.
APM ist meist der schnellste Einstieg, weil es pro Service Antwortzeiten, Durchsatz und Fehlerraten sichtbar macht und Baselines für Abweichungen erzeugt. Gerade bei verteilten Anwendungen hilft das, weil Teams nicht zuerst jedes Signal selbst instrumentieren müssen. Ein APM-System schafft einen ersten, belastbaren Blick auf Performance, bevor die tiefergehende Korrelation beginnt.
Strukturierte Logs, idealerweise als JSON oder key/value-Ereignisse, beantworten die Warum-Frage zu einem konkreten Request. Ohne Indexierung und klare Retention-Strategie werden sie allerdings schnell teuer und unübersichtlich. Deshalb sollten Logs nicht als universeller Datenspeicher missbraucht werden, sondern als gezielte Beweisführung für konkrete Fehlerbilder.
Metriken bleiben das Rückgrat für Dashboards, Kapazitätsplanung und SLO-Reporting. Tracing ergänzt das Ganze, weil es mit Spans und Trace-IDs sichtbar macht, wo eine Anfrage zwischen Frontend, API, Datenbank und externem Dienst hängenbleibt. Genau diese Verknüpfung macht in verteilten Teams den Unterschied, weil Remote-Entwickler denselben Pfad sehen wie Kolleginnen und Kollegen vor Ort.

Für die Entscheidung im Alltag hilft eine einfache Heuristik. Wenn der Service insgesamt auffällig reagiert, beginnt man mit APM und Metriken. Wenn ein einzelner Request rätselhaft ist, liefern Logs den Kontext. Wenn der Fehler über Servicegrenzen springt, braucht es Tracing.
"Wenn ein Ticket mit „ist irgendwie langsam“ startet, reichen Einzelmetriken selten aus. Dann braucht es den Pfad der Anfrage, nicht nur einen Grenzwert."
Die Logik passt gut zu modernen Plattformen wie Kubernetes, weil dort viele kleine Komponenten zusammenspielen und Zuständigkeiten auseinanderfallen können. Ein sauberer Observability-Ansatz schafft dann die gemeinsame Sprache für Infrastruktur- und Anwendungsteams (Kubernetes-Grundlagen).
Die eigentliche Tool-Frage beginnt nicht mit „Welche Oberfläche gefällt uns?“, sondern mit „Welche Datenhoheit, welche Standards und welche Integrationen brauchen wir wirklich?“. In der Praxis scheitern Monitoring-Stacks selten an zu wenig Funktionen, sondern an Tool-Silos, die neue Abhängigkeiten schaffen. Deshalb sollte die Auswahl bei offenen Standards, klaren Datenformaten und einer realistischen Kostenlogik starten.
OpenTelemetry ist dabei oft der wichtigste Filter, weil es Telemetrie standardisiert und den Wechsel zwischen Backends erleichtert. Wer zusätzlich Self-Hosting braucht, sollte früh klären, wie Datenhaltung, Retention und Zugriff geregelt werden. Bei SaaS-Modellen lohnt sich ein Blick auf Kosten pro Host oder pro Datenvolumen, weil das im Betrieb schnell relevanter wird als die Demo.
Open-Source-Stacks punkten dort, wo Kostenkontrolle und Flexibilität wichtiger sind als ein einziger Produktkatalog. All-in-One-APM ist sinnvoll, wenn ein Team schnell zu nutzbaren Korrelationen kommen muss und die Betriebsreife noch im Aufbau ist. Hybrid-Ansätze sind oft der pragmatische Mittelweg, besonders wenn bestimmte Daten intern bleiben müssen, andere aber schnell analysiert werden sollen.
Auch PandaNerds passt als Option in diesen Kontext, wenn Unternehmen neben dem Stack auch seniorige Remote-Entwicklungskapazität brauchen, um Monitoring, Instrumentierung und Betrieb gemeinsam aufzubauen. Entscheidend bleibt aber immer dieselbe Frage: Verbindet das Tool die Signale, oder zementiert es neue Silos?
"Entscheidungskriterium: Ein Tool lohnt sich nur, wenn es Incident-Auflösung schneller macht, nicht bloß Dashboards schöner."
Monitoring funktioniert nicht, weil ein Agent installiert wurde. Es funktioniert, wenn ein Team gelernt hat, seine Systeme in der richtigen Reihenfolge zu betrachten. Ich starte deshalb immer mit einem Golden-Signal-Inventar, also Latenz, Traffic, Errors und Saturation pro Service, bevor irgendein umfassender Rollout beginnt. So wird klar, welche Services wirklich kritisch sind.
Danach kommen SLI-Definitionen, SLOs und ein erstes Dashboard-Set, das nur eine Aufgabe hat, die Fragen der On-Call-Engineers zu beantworten. Wenn ein Dashboard niemand im Dienst nutzt, ist es kein Steuerungsinstrument, sondern Deko. Diese Disziplin spart später viel Reibung, weil sich Owner und Nutzung von Anfang an an derselben Frage ausrichten.
Tracing sollte in Microservices-Architekturen früh aktiv werden, weil dort die Wege zwischen den Diensten sonst schnell unsichtbar bleiben. In Monolithen kann es warten, solange Metriken und Logs sauber laufen. Der häufigste Fehler ist nicht die Technik, sondern die Organisationsform, fehlende Service-Owner, Custom-Metriken ohne Kardinalitätsgrenze und Dashboards, die niemandem wirklich gehören.
"Praxisregel: Erst Ownership, dann Instrumentierung, dann Dashboards. Sonst entsteht nur Messung ohne Verantwortung."
Ein solches Vorgehen macht in wenigen Wochen einen deutlichen Unterschied, weil echte Vorfälle sichtbar werden und nicht nur hübsche Kurven entstehen. Gerade in verteilten Teams ist das Gold wert, weil Remote-Senior-Entwickler dann auf dieselbe Lage schauen wie das restliche Team und nicht erst Kontext einsammeln müssen.
Die meisten Alarmprobleme sind kein Konfigurationsfehler, sondern ein Designfehler. Wenn Teams mehr Alerts bekommen, als sie bearbeiten können, und wöchentliche Fehlalarme zum Alltag gehören, verliert Monitoring seine Glaubwürdigkeit sehr schnell. Ein sinnvoller Alert ist deshalb nicht „irgendetwas ist anders“, sondern „hier muss jemand handeln“.
Alerting sollte sich an SLOs orientieren, nicht an einzelnen Metrik-Schwellwerten. Ein leicht steigender Latenz-P99 ist oft noch kein Vorfall, ein spürbarer Verbrauch des Error Budgets schon eher. Burn-Rate-Alerts helfen dabei, schnelle von langsamen Budgetverbrennungen zu unterscheiden und echte Risiken früher sichtbar zu machen.
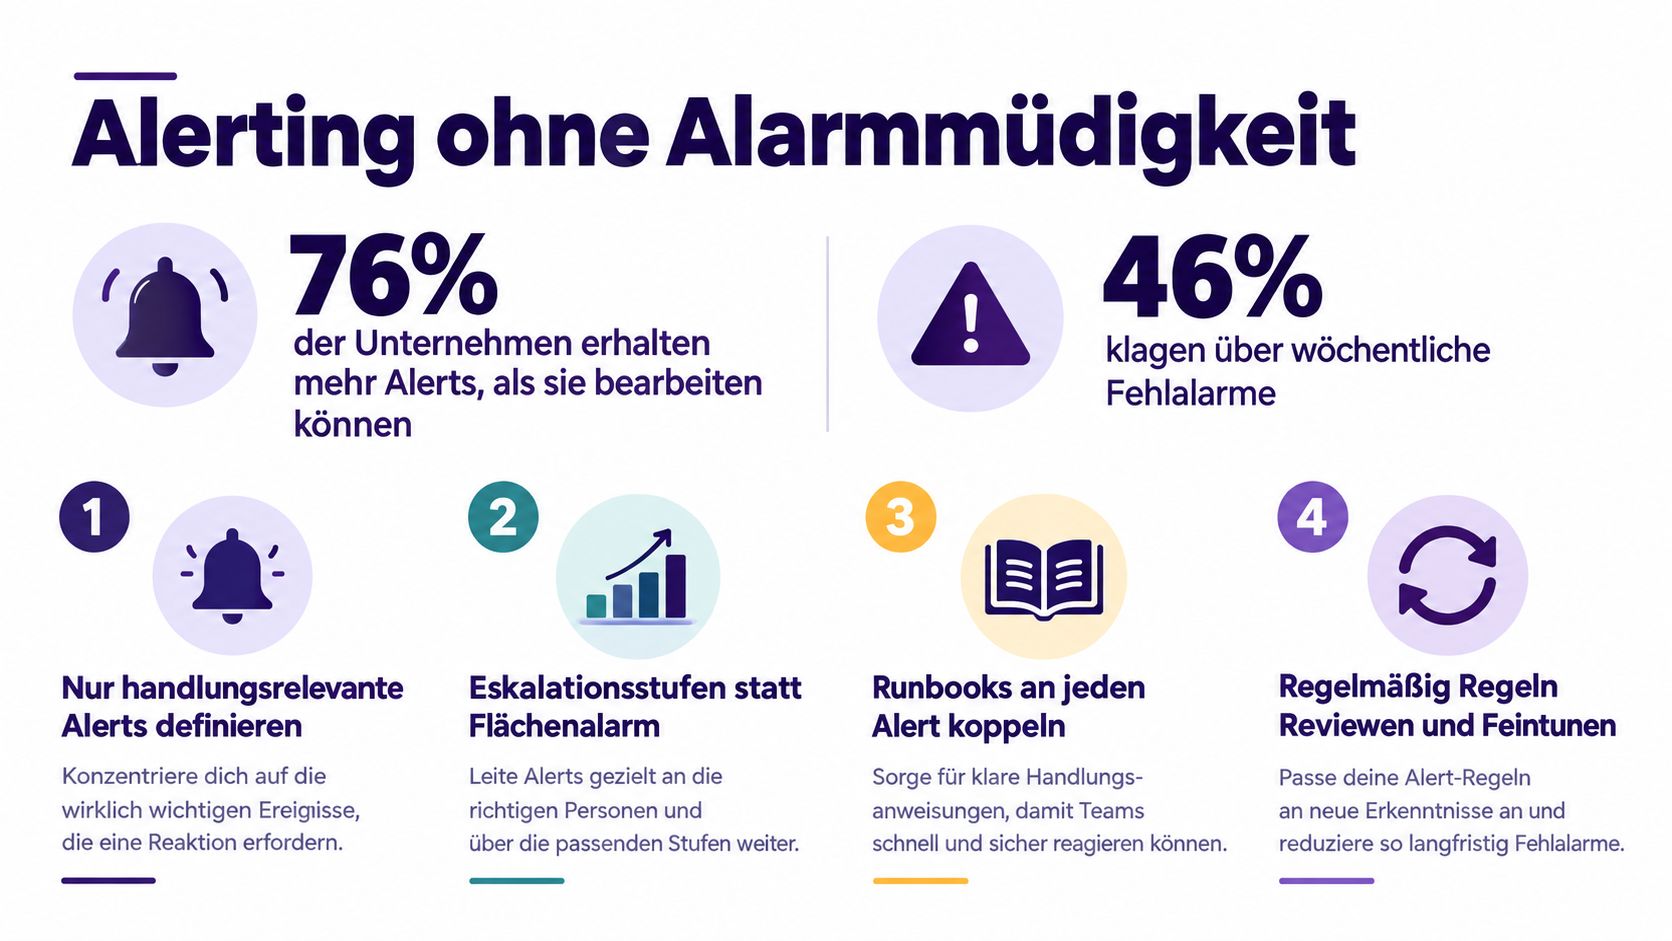
Runbooks gehören direkt an den Alert, nicht in ein Wiki, das niemand im Ernstfall öffnet. Sie müssen Owner, Eskalationspfad und erste Diagnoseschritte nennen, sonst bleibt der Alarm zwar laut, aber nicht hilfreich. Wer Regeln regelmäßig reviewt, Thresholds bereinigt und irrelevante Meldungen konsequent entfernt, reduziert Pager-Lärm spürbar und schafft Vertrauen in das System.
Die deutsche Praxislage zeigt, warum das so wichtig ist. Laut Studie erzeugen Monitoring- und Management-Tools täglich im Schnitt 2.624 Alerts, nur 22 % davon erfordern wirklich eine Aktion, Teams verbringen 9 % ihrer Zeit damit, relevante von irrelevanten Meldungen zu trennen, und das kostet im Mittel 860.000 Euro pro Jahr (AP Verlag). Für die Bedienlogik heißt das, weniger Alerts, dafür bessere, und ein hartes Review jedes Signalwegs.
Ein gutes Monitoring-Setup beschleunigt nicht nur Incidents, sondern auch Onboarding. Wenn ein neuer Senior-Entwickler am ersten Tag Dashboards, Service Maps und Runbooks vorfindet, kann er oder sie produktiv mitarbeiten, ohne erst drei Teams nach Kontext zu fragen. In Remote-Setups spart das besonders viel Zeit, weil implizites Wissen sonst mühsam über Chats, Calls und Screenshares verteilt wird.
Deutschland ringt weiter mit Fachkräftemangel, und laut Bitkom betrifft das 85 Prozent der deutschen Unternehmen. Genau deshalb ist Monitoring auch ein Produktivitätswerkzeug, nicht nur ein Betriebswerkzeug. Wer historische Incident-Daten, SLO-Reports und Verteilungsdiagramme sauber aufbereitet, ersetzt einen Teil des Systemwissens durch belastbare, geteilte Sicht.
Für die ROI-Frage hilft eine einfache Gegenüberstellung: Monitoring-Jahreskosten × Faktor 3 auf der einen Seite, erwartete Ausfallstunden × Stundensatz auf der anderen. Diese Heuristik ist absichtlich grob, aber sie zwingt dazu, nicht nur Toolkosten zu betrachten, sondern den Wert vermiedener Ausfälle. Das ist oft der sauberste Weg, um Engineering- und Recruiting-Lead an einen Tisch zu bekommen.
Die Verbindung zu Remote-Teams ist dabei direkt. Das passende Material zum virtuellen Einarbeiten findet sich auch bei Remote-Onboarding im Homeoffice, denn gute Einarbeitung und gutes Monitoring hängen enger zusammen, als viele denken. Beide reduzieren Reibung, beide machen Wissen übertragbar, und beide zahlen auf dieselbe Kennzahl ein, schnell arbeitsfähig werden.
"Ein Team, das Performance sichtbar macht, onboardet neue Leute schneller und reagiert in Incidents sauberer. Genau diese doppelte Wirkung macht den Investitionsfall stark."
PandaNerds unterstützt Unternehmen dabei, seniorige Remote-Entwickler so einzubinden, dass Monitoring, Instrumentierung und Umsetzung nicht an Schnittstellen hängen bleiben. Wenn du Performance Monitoring in Softwareprojekten belastbar aufbauen willst, schau dir an, wie PandaNerds Teams mit passgenauen Entwicklern und sauberem Onboarding entlastet.