02.07.2025
Asana vs. Trello: Welches Projektmanagement-Tool ist besser?
Asana vs. Trello: Welches Projektmanagement-Tool ist besser? Wir vergleichen beide Tools im Projektmanagement. Welches Tool passt besser zu Ihren Zielen?
get started


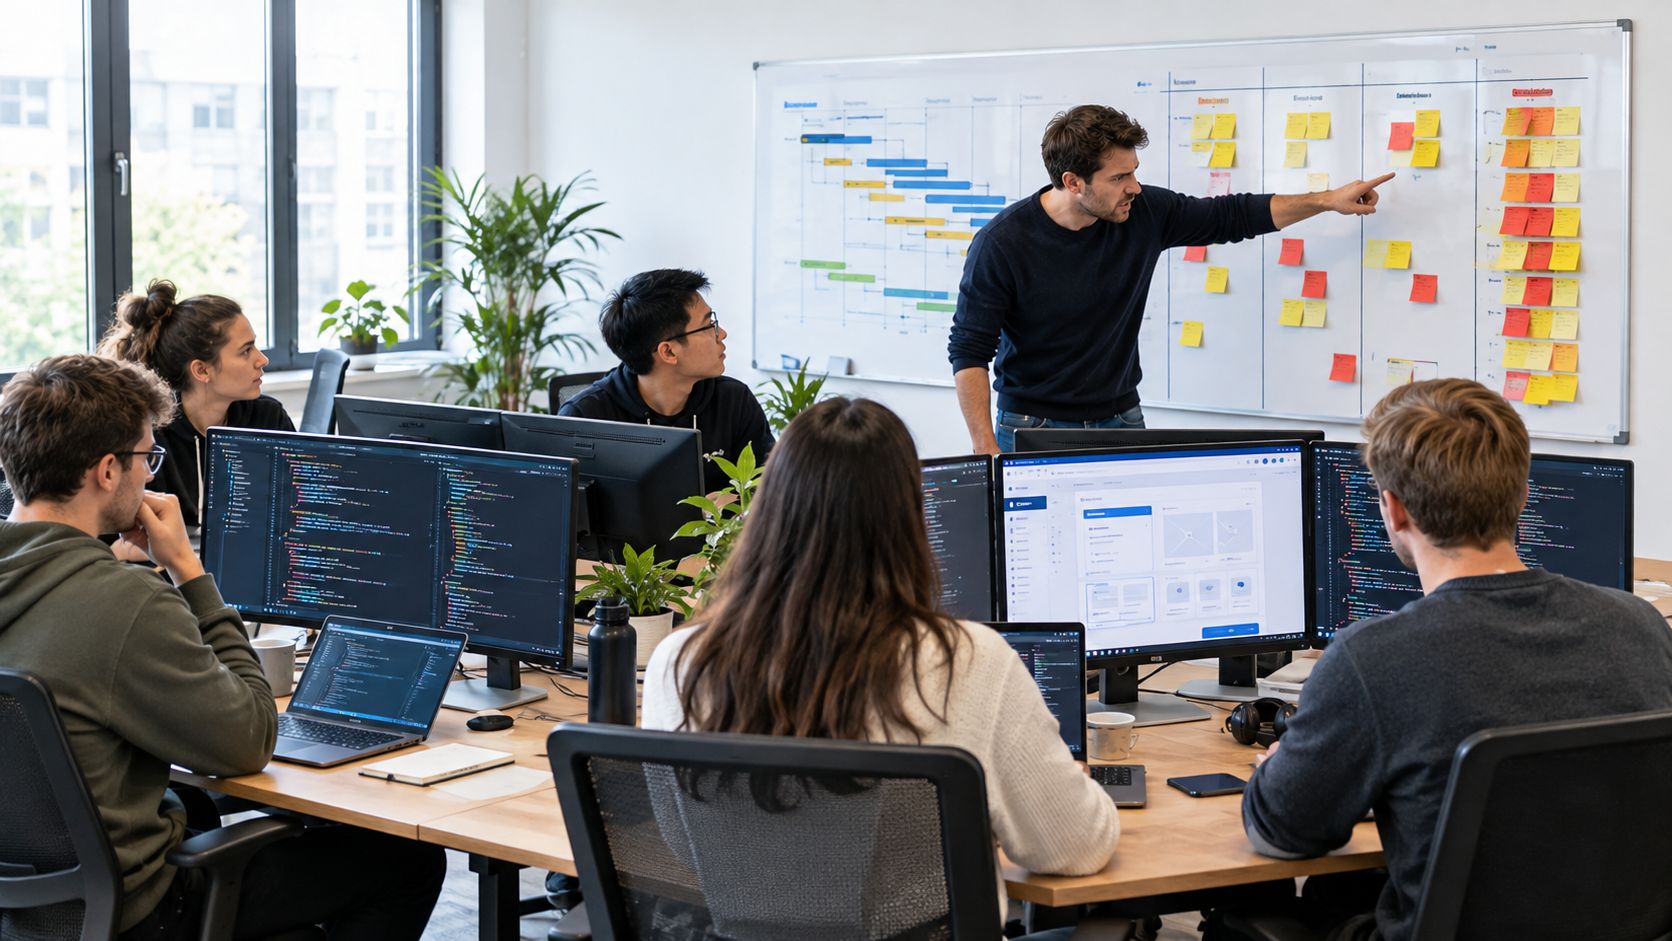
Am Quartalsanfang sieht die Roadmap noch machbar aus. Dann meldet der Vertrieb, dass das neue B2B-Portal vor einem wichtigen Kundentermin fertig sein muss. Gleichzeitig hängt die Cloud-Migration hinterher, zwei Sicherheitslücken brauchen einen Patch, und die Geschäftsführung möchte ein KI-Proof-of-Concept sehen. Das Team besteht aus sechs Entwicklern. Zusätzliche Stunden lassen sich nicht einfach herbeiplanen.
Die Entscheidung ist nicht, ob all diese Aufgaben wichtig sind. Sie ist, welche Arbeit zuerst Kapazität bekommt und nach welchen Regeln. Resource Allocation im Engineering bedeutet, knappe Entwicklerzeit bewusst zu verteilen, statt jedem Vorhaben ein bisschen Zeit zu geben und am Ende nichts verlässlich auszuliefern. Wer die Regeln dafür festlegt, bestimmt, was das Team tatsächlich baut, absichert und betreibt.
Am Ende geht es um drei praxistaugliche Methoden, drei Kennzahlen und fünf verbreitete Allokationsfehler. Der Überblick zu Jira Advanced Roadmaps kann helfen, Abhängigkeiten und geplante Kapazitäten sichtbar zu machen. Aber ein Tool trifft die schwierigen Entscheidungen nicht für euch. Das muss die Engineering-Führung tun.
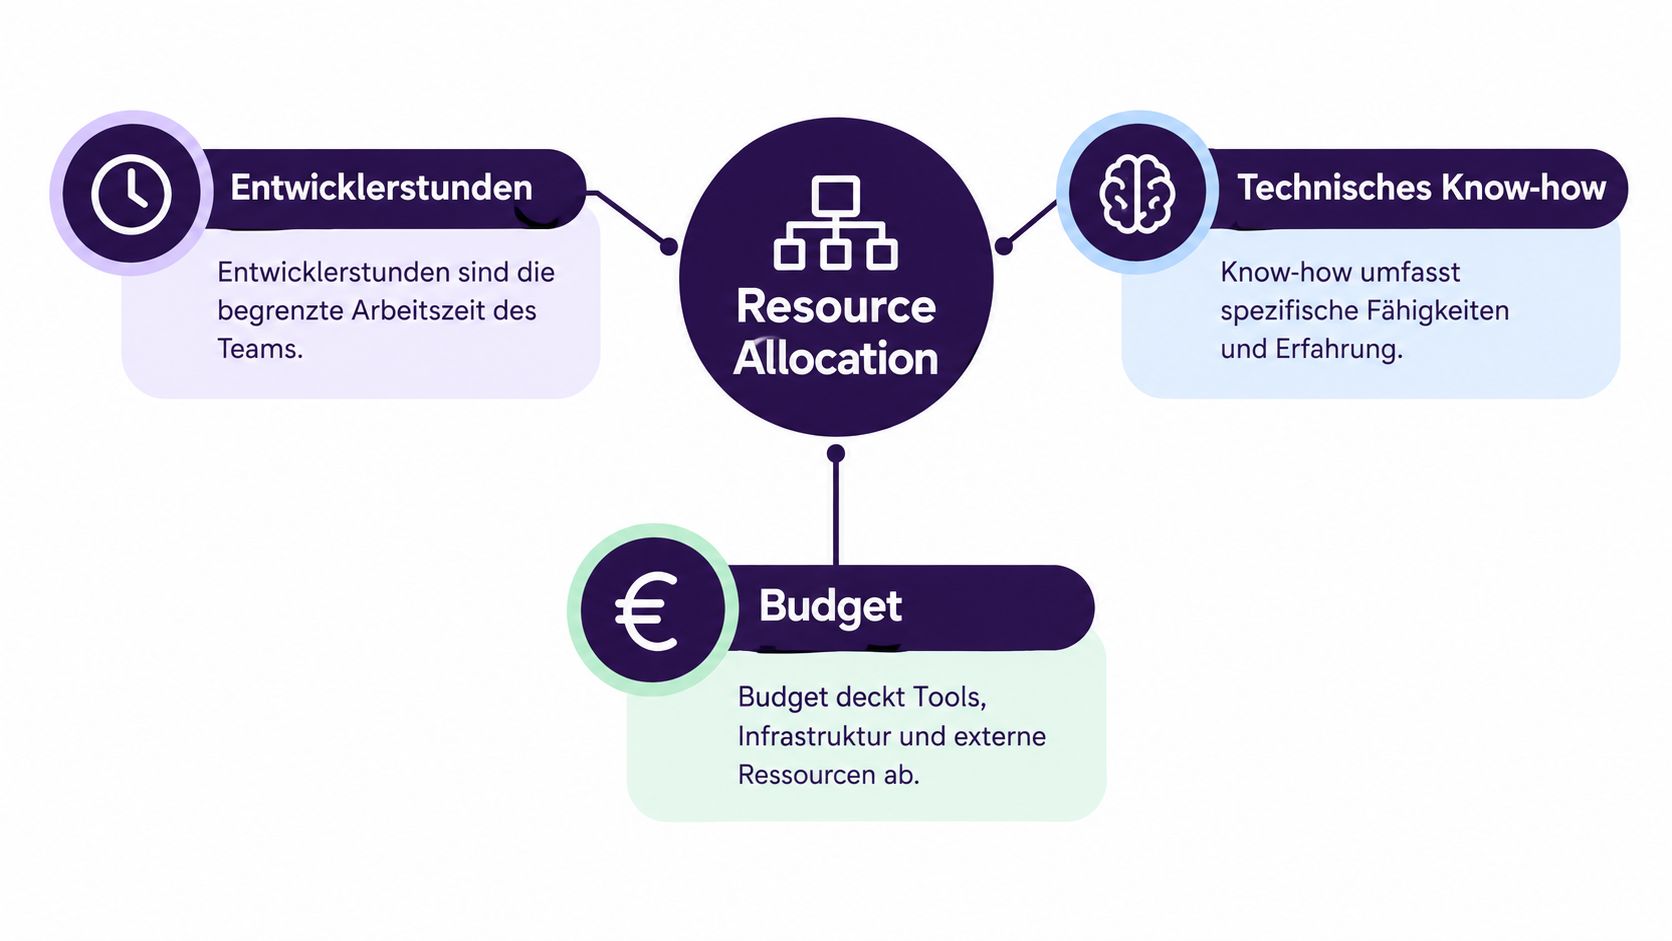
Resource Allocation ist mehr als die Frage, wer an welchem Ticket arbeitet. Im Engineering verteilt ihr vor allem qualifizierte Entwicklerstunden, technisches Know-how und Fokuszeit auf konkurrierende Aufgaben. Dazu gehören Produktentwicklung, Betrieb, Sicherheit, Compliance und technische Schulden. Entscheidungskapazität zählt ebenfalls: Wenn jede Priorität erst durch mehrere Abstimmungsrunden muss, verliert das Team Zeit, bevor es überhaupt loslegt.
Denkt an mehrere Töpfe, die aus einem begrenzten Vorrat gefüllt werden. Der Unterschied zur reinen Budgetplanung: Ihr verteilt nicht nur Geld, sondern auch Fähigkeiten und zusammenhängende Arbeitszeit. Ein Senior-Engineer, der eine kritische Architekturentscheidung treffen kann, ist nicht ohne Weiteres durch eine zusätzliche Person ohne dieses Erfahrungswissen zu ersetzen. Und wer zu viele Aufgaben parallel startet, verteilt den Fokus so dünn, dass Tickets liegen bleiben und Kontextwechsel die Umsetzung erschweren.
Strategie legt fest, welche Geschäftsergebnisse Vorrang haben. Wenn Ausfallsicherheit ein Muss ist, darf das Team kritische Betriebsarbeit nicht zugunsten eines zusätzlichen Features verdrängen.
Kapazität klärt, welche Menschen und Fähigkeiten tatsächlich verfügbar sind. Plant nicht mit nomineller Teamgröße. Berücksichtigt Meetings, Bereitschaftsdienst, Abwesenheiten und notwendige Zusammenarbeit.
Taktik bestimmt, wie Aufgaben umgesetzt und nachgesteuert werden. Dazu gehören Verantwortlichkeiten, Reihenfolge und Regeln, wann das Team ein Vorhaben stoppt oder neu bewertet.
Diese Entscheidungen werden durch den Fachkräftemangel zusätzlich erschwert. Im April 2023 meldeten 42,2 Prozent der befragten Unternehmen in Deutschland eine Behinderung ihrer Geschäftstätigkeit durch fehlendes Fachpersonal; bei Dienstleistungsunternehmen lag der Anteil bei 47,4 Prozent (KfW zur Fachkräfteknappheit). Für CTOs heißt das: Allokation umfasst auch die Frage, wie interne Arbeit sinnvoll abgegrenzt und fehlendes Spezialwissen bei Bedarf extern ergänzt wird. Das Budget kann vorhanden sein, doch ohne passende Kompetenzen kommt das Vorhaben trotzdem nicht voran.
Beginnt mit der verfügbaren Kapazität, nicht mit einer Wunschliste. Zieht von der Arbeitszeit zunächst Meetings, Bereitschaftsdienst, Support und andere feste Verpflichtungen ab. Was übrig bleibt, ist die Grundlage für Zusagen. Plant nicht jede freie Stunde ein. Wenn keine Reserve für ungeplante Betriebsarbeit bleibt, kippt die Roadmap beim ersten dringenden Vorfall.
Anschließend braucht ihr eine nachvollziehbare Priorisierung. RICE hilft, Vorhaben anhand von Reichweite, Wirkung, Sicherheit der Einschätzung und Aufwand zu vergleichen. WSJF eignet sich, wenn ihr den Verzögerungsschaden gegen die Größe des Vorhabens abwägt. MoSCoW sortiert Anforderungen nach Muss, Soll, Kann und Nicht jetzt. Keine Methode entscheidet automatisch richtig. Ihr braucht eine gemeinsame Regel, die Stakeholdern zeigt, warum ein Vorhaben Vorrang erhält und welches andere warten muss. Für konkrete Vorgehensweisen beim Sortieren könnt ihr die Tipps für Ressourcenplanung 2026 als ergänzende Orientierung nutzen.
Steuerung hält die Entscheidung im Alltag zusammen. Ein WIP-Limit begrenzt, wie viel gleichzeitig begonnen wird. Timeboxing gibt einem Experiment oder einer Analyse ein festes Zeitfenster. RACI klärt, wer verantwortlich ist, wer entscheidet, wer konsultiert wird und wer informiert werden muss. Für kleine Teams würde ich mit Kapazitätsplanung, RICE und Timeboxing anfangen. Größere Strukturen brauchen zusätzlich klare Verantwortlichkeiten und ein Verfahren für Abhängigkeiten.
"Praktische Regel: Prioritäten sind nur dann echt, wenn ihr auch benennen könnt, welche Arbeit dafür wartet."
Haltet die Reihenfolge im Backlog sichtbar und besprecht Änderungen, sobald sich Geschäftswert, Risiken oder Lieferbedingungen verschieben. Eine klare Backlog-Priorisierung macht die Entscheidung überprüfbar, statt sie in Einzelgesprächen verschwinden zu lassen.
Lasst euch nicht von einem Dashboard mit vielen Zahlen beeindrucken. Für Allokationsentscheidungen reichen zunächst drei Kennzahlen, wenn ihr sie ehrlich erhebt: verfügbare Entwicklerstunden, Cost of Delay und Cycle Time. Jede beantwortet eine andere Frage. Wie viel könnt ihr realistisch liefern? Was kostet das Warten? Und wo stockt die Arbeit?
Verfügbare Entwicklerstunden pro Sprint sind die Teamstunden, die nach Abzug von Meetings, Bereitschaft, Support und anderen festen Aufgaben für geplante Entwicklungsarbeit bleiben. Addiert nicht einfach die Arbeitszeit aller Beschäftigten. Erfasst die Kapazität, die tatsächlich für fokussierte Umsetzung bereitsteht. Ist sie niedriger als geplant, müsst ihr Umfang oder Zusagen anpassen, statt Überstunden als Puffer zu behandeln.
Cost of Delay ist der erwartete Schaden, wenn ein Vorhaben später fertig wird. Schätzt ihn mit den zuständigen Fachbereichen anhand konkreter Folgen: etwa verschobener Umsatz, ein verlängertes Sicherheitsrisiko oder ein blockierter Kundeneinsatz. Ihr müsst keine Scheingenauigkeit erzeugen. Eine begründete Einschätzung reicht, um dringende Arbeit von einer bloß lauten Anfrage zu unterscheiden.
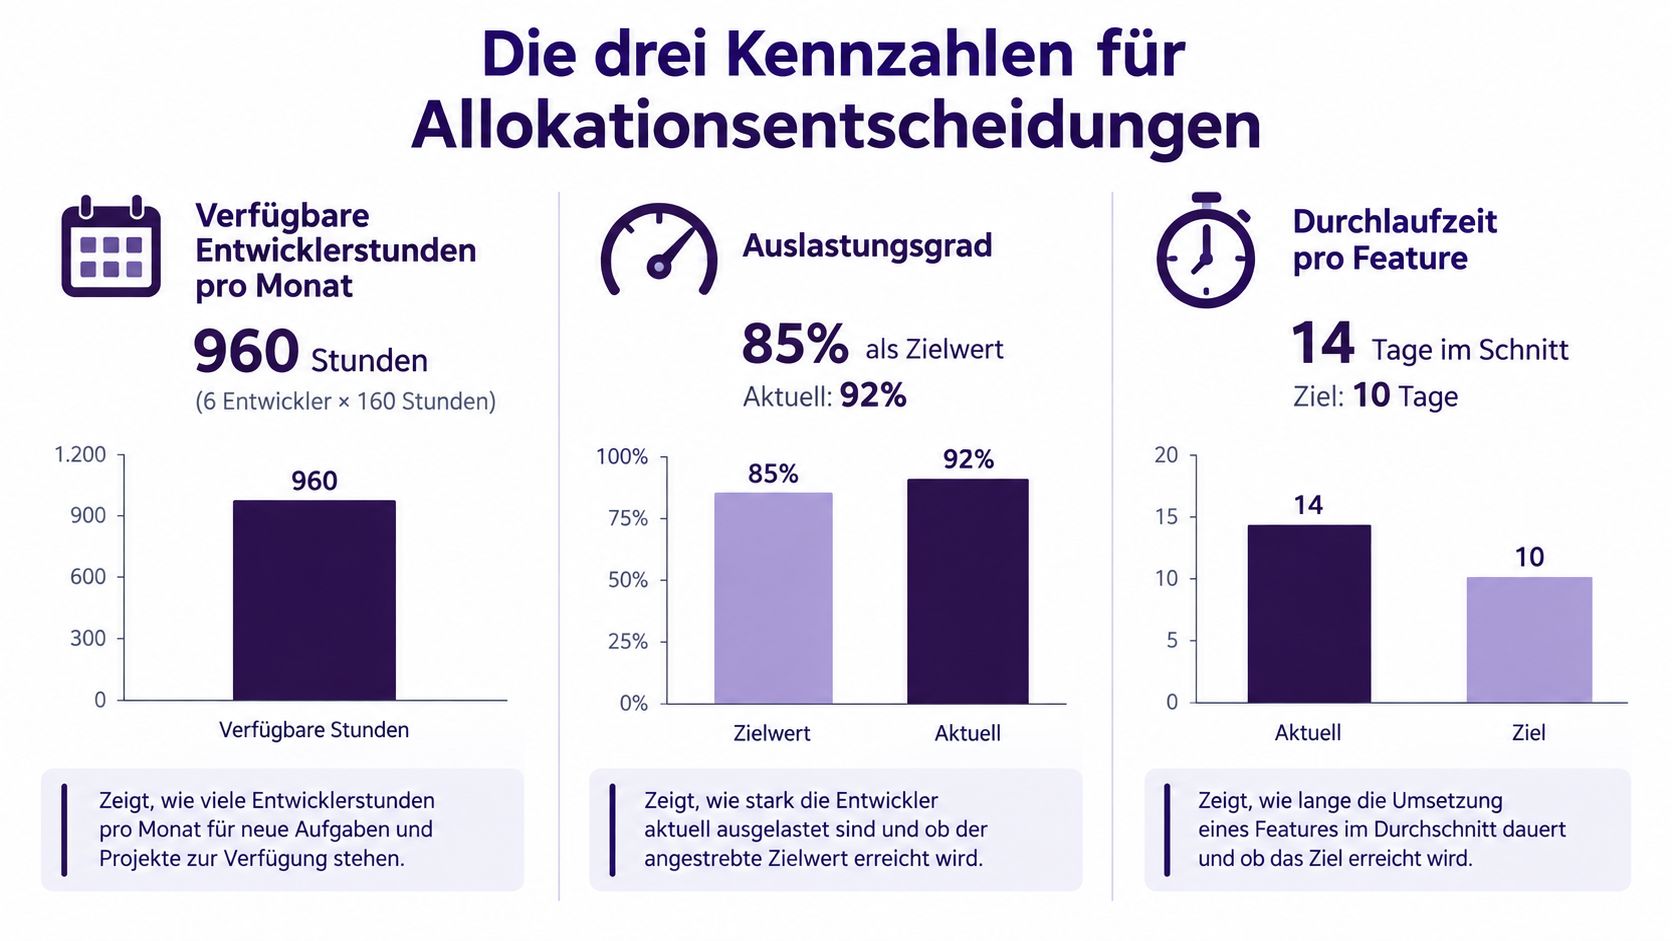
Cycle Time misst die Zeit vom Arbeitsbeginn eines Tickets bis zum Merge. Nutzt einen konsistenten Start- und Endpunkt und betrachtet den Verlauf über vergleichbare Arbeit. Eine steigende Cycle Time kann auf zu große Tickets, blockierte Reviews oder zu viel parallele Arbeit hinweisen. Sie ist kein Beweis dafür, dass Entwickler zu langsam arbeiten. Prüft den Prozess, bevor ihr Kapazität verschiebt.
Verbindet die Kennzahlen, bevor ihr den Plan ändert. Wenn die verfügbaren Stunden sinken, aber ein Vorhaben hohe Verzögerungskosten hat, müsst ihr andere Arbeit bewusst zurückstellen. Wenn Tickets lange offenbleiben, untersucht erst den Engpass. Ein Progress Reporting für Engineering-Teams sollte solche Veränderungen sichtbar machen, ohne aus Aktivität einen Ersatz für Ergebnisse zu machen.
"Wenn ihr den Verzögerungsschaden nicht seriös einschätzen könnt, verbessert zuerst eure Sicht auf Arbeitsfluss und Blockaden. Sonst verteilt ihr Kapazität nach Vermutung."
Eine Kennzahl ist nur dann nützlich, wenn sie eine konkrete Entscheidung verändert. Schreibt deshalb zu jeder Planungsrunde auf, welche Annahme ihr mit den Zahlen überprüft und welche Arbeit ihr bei neuen Erkenntnissen stoppt oder verschiebt.
Ein Kölner SaaS-Mittelständler will ein KI-Chatbot-Experiment starten, ohne das Kernprodukt auszubremsen. Die CTO legt ein separates Kapazitätskontingent fest und gibt dem Experiment ein eng umrissenes Ziel: Es soll zeigen, ob ein klar definierter Supportprozess mit den verfügbaren Daten zuverlässig unterstützt werden kann. Ein Engineer erhält die Verantwortung für Umsetzung und Abstimmung mit dem Product Owner. Vor dem Start werden Baseline, Datenzugriff und Abbruchkriterium festgehalten.
Die Entscheidung ist nicht, dass KI wichtiger sei als das Produkt. Sie ist, das Experiment als begrenzte Wette zu behandeln. Wenn Datenqualität oder rechtliche Prüfung den Einsatz verhindern, wird nicht weiterentwickelt, nur weil bereits Zeit investiert wurde. Das Team dokumentiert Ergebnisse und offene Risiken, damit der nächste Beschluss auf Erkenntnissen statt auf Hoffnung beruht.
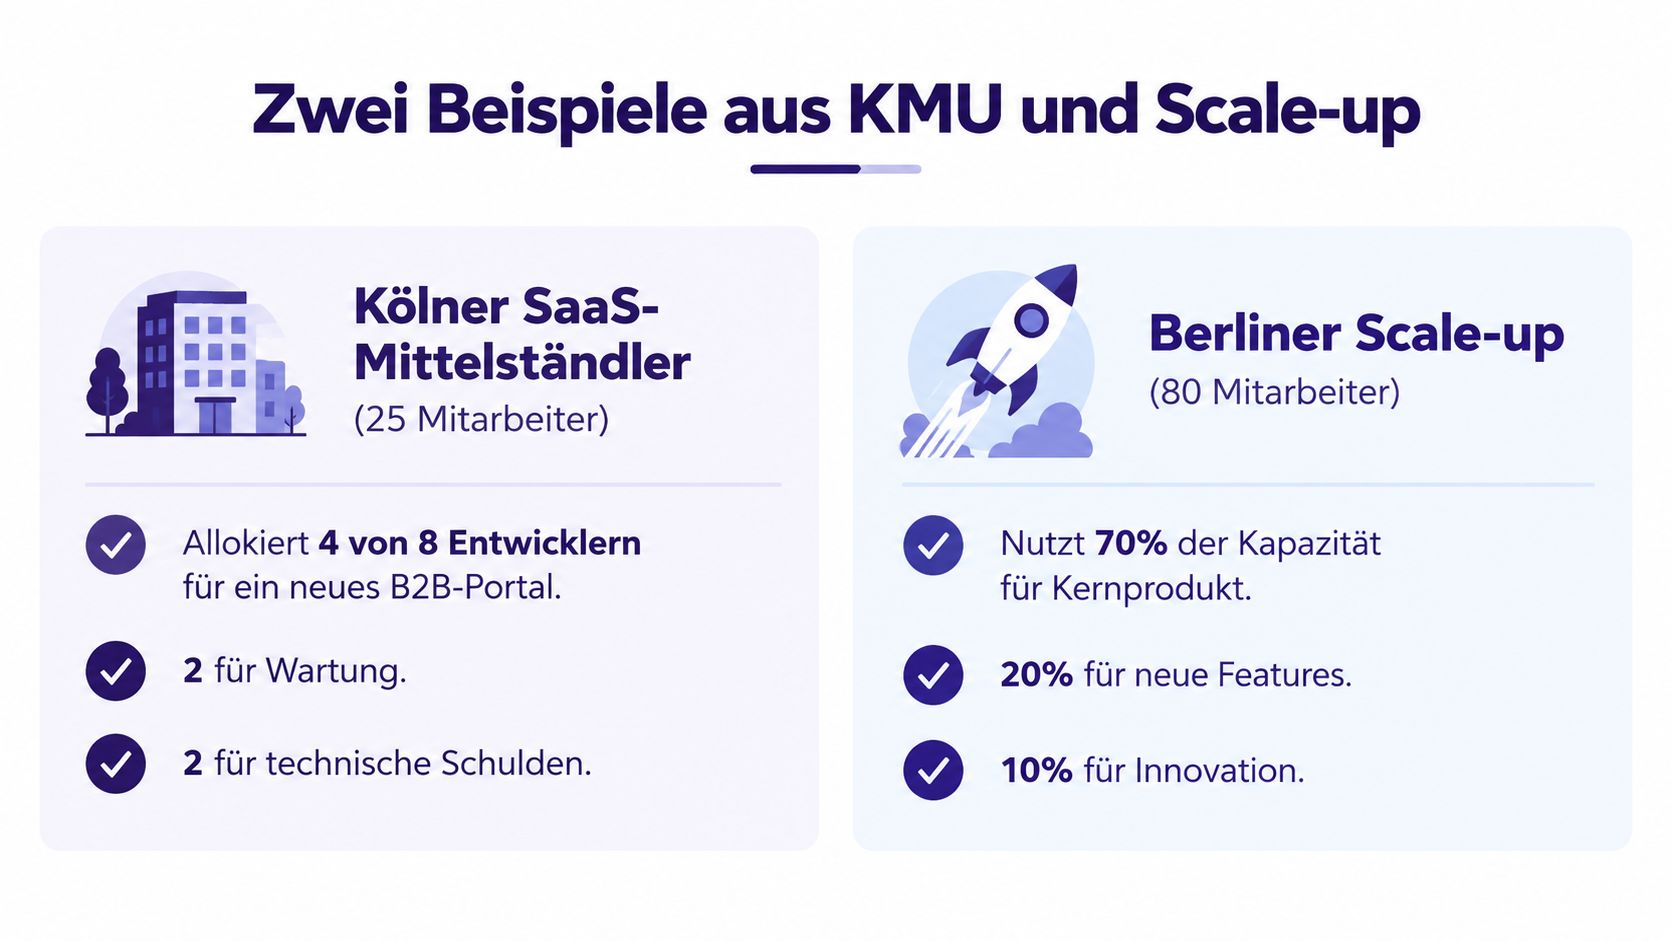
Ein Frankfurter Fintech-Scale-up muss ein Datenschutz- und Sicherheitsaudit, eine neue Zahlungsintegration und ein Plattform-Refactoring unterbringen. Die Engineering-Leitung priorisiert zunächst das Audit, weil offene Compliance-Risiken nicht einfach in den nächsten Planungszyklus verschoben werden sollten. Für die Integration stellt sie ein klar abgegrenztes internes Team auf. Das Refactoring wird nur dann extern vergeben, wenn Umfang, Schnittstellen und Abnahmekriterien so definiert sind, dass externe Senior-Entwickler es ohne dauernde Unterbrechungen durch das Kernteam bearbeiten können.
In beiden Fällen braucht die Entscheidung einen messbaren Prüfpunkt. Beim Experiment zählt, ob die gewünschte Prozessunterstützung mit akzeptabler Datenqualität möglich ist. Bei der extern vergebenen Arbeit zählen vereinbarte Ergebnisse und eine saubere Übergabe, nicht bloß ausgelastete Stunden.
Solche Beispiele sind Entscheidungsmodelle, keine Erfolgsversprechen. Die konkreten Kapazitätsaufteilungen in der Infografik sind ebenfalls illustrative Darstellungen und keine Empfehlung, die sich auf jedes Unternehmen übertragen lässt. Wählt die Aufteilung nach Risiko, Geschäftswert und verfügbaren Fähigkeiten, nicht nach einer pauschalen Quote.
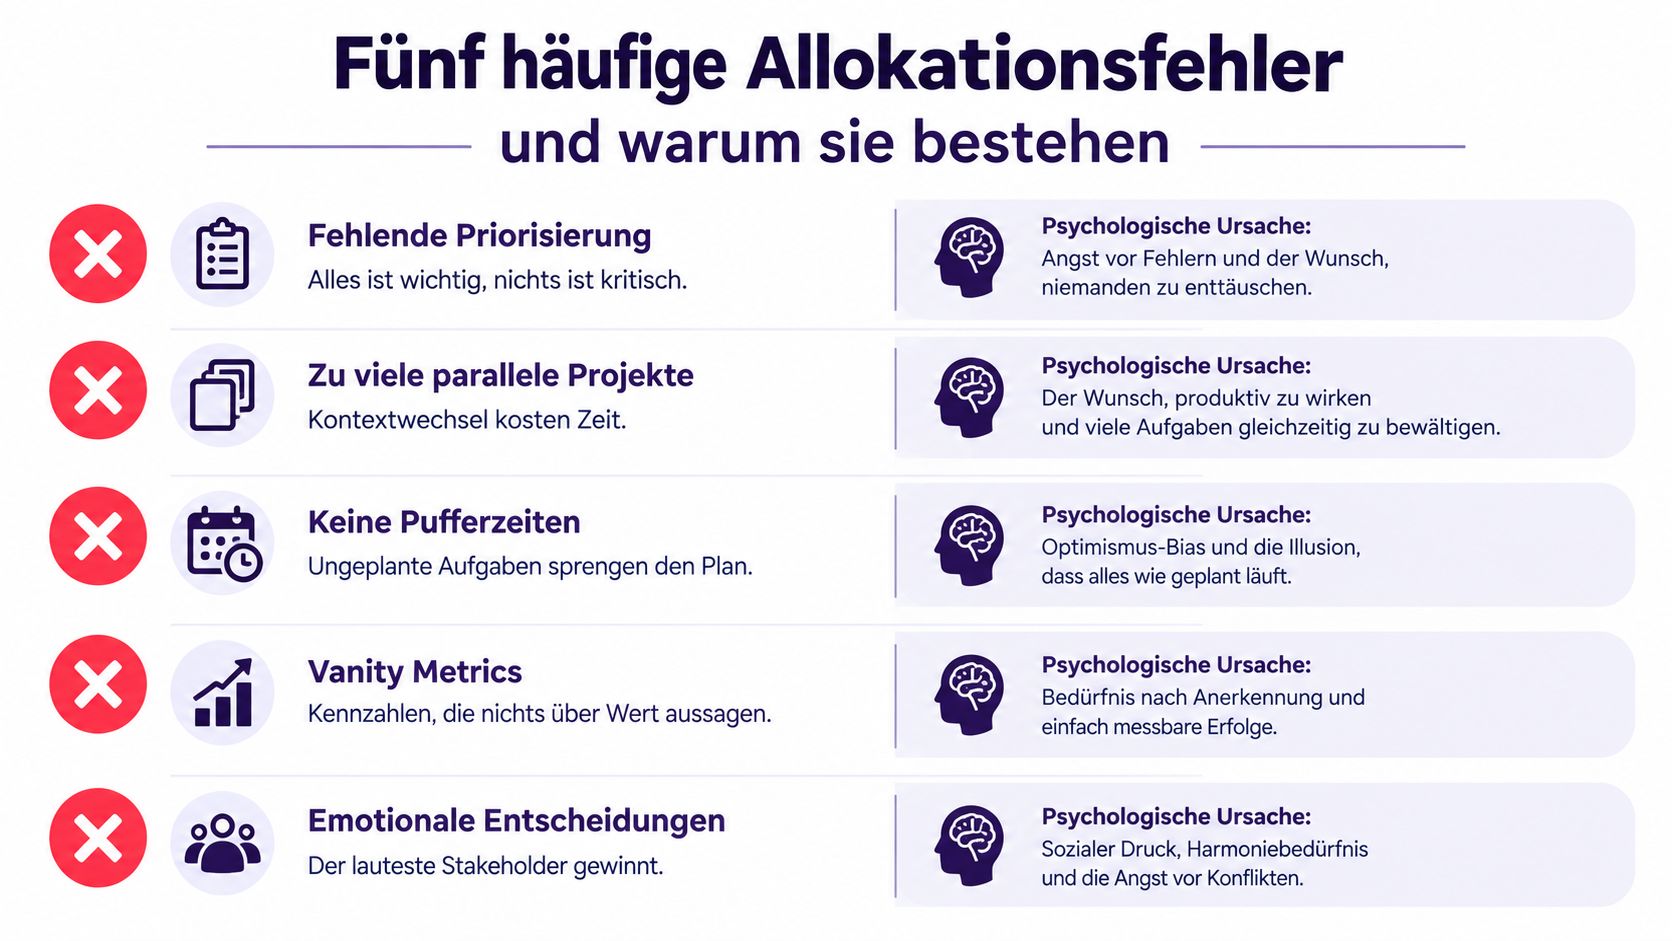
Helden-Kultur: Nur wenige erfahrene Entwickler dürfen kritische Arbeit anfassen. Das wirkt effizient, bis sie zum Engpass werden oder ausfallen. Pair-Programming, Reviews und rotierende Bereitschaft verteilen Wissen, statt es an Einzelpersonen zu binden. „Die anderen sind noch nicht so weit“ ist kein Grund, Wissen dauerhaft zu monopolisieren.
Feature-Fabrik: Das Team liefert neue Funktionen, während technische Schulden und Betrieb immer weiter zurückfallen. Der Einwand, man könne Schulden später bezahlen, ignoriert das Risiko, dass spätere Änderungen dadurch teurer oder gefährlicher werden. Reserviert Kapazität für konkret benannte technische Risiken und prüft deren Auswirkungen im Review.
Shared Resources ohne Owner: Mehrere Projekte beanspruchen dieselben Personen, aber niemand entscheidet verbindlich über Reihenfolge und Konflikte. Das endet in Abstimmungen statt Lieferung. Benennt eine direkt verantwortliche Person und klärt Entscheidungsrechte mit RACI. Ein geteiltes Team ohne Priorisierungsinstanz ist keine flexible Kapazität, sondern eine Warteschlange.
KI-Experimente ohne Abbruchkriterium: Ein Prototyp bindet erfahrene Entwickler, weil niemand den Moment festgelegt hat, an dem die Idee verworfen wird. Das Risiko ist nicht nur technische Unsicherheit, sondern fehlende Governance. Im Jahr 2025 nannten 53 Prozent der deutschen Unternehmen rechtliche Unsicherheiten und 51 Prozent fehlende personelle Ressourcen als zentrale Hemmnisse beim KI-Einsatz; zugleich stellten nur 5 Prozent gezielt Fachkräfte mit KI-Kenntnissen ein (Bitkom zur KI-Nutzung in Unternehmen). Legt vor dem Start Baseline, verantwortliche Person und Stage-Gate fest.
Versteckte technische Schulden: Das Team verschiebt Wartung, weil sie im Statusbericht schlechter aussieht als ein neues Feature. Die Arbeit verschwindet nicht, sie taucht später als Fehler, Verzögerung oder Sicherheitsrisiko wieder auf. Bei verteilten Hardware- und Softwareverantwortlichkeiten lohnt sich zudem ein Blick auf die Folgen der Trennung von Hardware- und Softwareteams, besonders wenn gemeinsame technische Abhängigkeiten unklar bleiben.
Verteilt Entwicklerstunden nach Geschäftswert, Risiko und verfügbarer Kompetenz, nicht nach dem Prinzip der fairen Gleichverteilung. Gleichverteilung ist leicht zu erklären und selten richtig. Prüft zuerst, welche Arbeit umsatz- oder sicherheitskritisch ist. Danach reserviert ihr Kapazität für notwendige technische Schulden. Experimente bekommen nur dann Raum, wenn sie eine klare Hypothese und einen Abbruchpunkt haben.
Ein fixer Split ist kein universelles Rezept. Ein Team mit akuten Sicherheitsrisiken braucht mehr Kapazität für Betrieb und Absicherung. Ein Produkt mit validierter Nachfrage rechtfertigt Vorrang fürs Kernprodukt. Legt eine Ausgangsverteilung fest, prüft sie an euren tatsächlichen Verpflichtungen und ändert sie, sobald sich das Risiko- oder Nachfragebild verschiebt.
Meine Faustregel: Wird der Bedarf in Wochen gemessen und bleibt die Einarbeitung unter zwei Wochen, holt euch externe Verstärkung. Läuft derselbe Kompetenzbedarf über sechs Monate, prüft eine Festanstellung, weil sie Wissen dauerhaft im Unternehmen verankert. Dazwischen liegt die Zone, in der ihr rechnen müsst: Einarbeitungszeit, Einstiegskosten und die Frage, ob die Lücke mit der Produktroadmap wächst oder schrumpft.
Die Engpassanalyse der Bundesagentur für Arbeit weist weiterhin eine große Zahl an Engpassberufen aus. Der deutsche Fachkräftemangel ist damit kein Recruiting-Problem, das sich wegbewerben lässt. Recruiting allein ist kein Kapazitätsplan. Festanstellung, externe Verstärkung und Automatisierung gehören in dasselbe Kapazitätsportfolio, nicht in getrennte Budgets. PandaNerds vermittelt geprüfte Senior-Remote-Entwickler, die je nach Bedarf in Vollzeit oder Teilzeit in bestehende Teams integriert werden können. Das ist eine Option, wenn ihr eine klar definierte Lücke schneller schließen wollt, als es ein klassischer Einstellungsprozess erlaubt.
Nehmt diese Fragen ins nächste Planning mit:
Beantwortet die Fragen, bevor neue Arbeit ins Sprint- oder Quartalscommitment rutscht. So wird Resource Allocation zu einer Reihe überprüfbarer Entscheidungen statt zu einem nachträglichen Versuch, Überlastung zu erklären.
Wenn euer Team kurzfristig Senior-Kapazität braucht oder eine Produktidee mit klar abgegrenztem Umfang umsetzen möchte, kann PandaNerds passende Entwickler in bestehende Engineering-Teams integrieren. Besprecht euren Kapazitätsengpass und eure Prioritäten mit PandaNerds, um zu prüfen, ob externe Verstärkung zu eurem Vorhaben passt.